Od dawna korzystam z chatbotów w chmurze. Ponieważ duże modele językowe wymagają ogromnej mocy obliczeniowej, te programy były jedyną dostępną opcją. Jednak dzięki LM Studio i LLM Quantum Models mogę teraz uruchamiać dobre modele offline, korzystając ze sprzętu, który już posiadam. To, co zaczęło się jako ciekawość lokalnej sztucznej inteligencji, przerodziło się w potężną alternatywę, która nic nie kosztuje, działa offline i daje mi pełną kontrolę nad interakcjami ze sztuczną inteligencją.

Ta zmiana stała się konieczna, gdy osobiście doświadczyłem, co się dzieje, gdy przypadkowo udostępnia się poufne informacje sztucznej inteligencji w chmurze. W efekcie udostępniłem swój kod PIN ChatGPT podczas rozmowy, która wydawała się zwyczajna. Ta chwila nieuwagi uświadomiła mi, że traktowałem sztuczną inteligencję w chmurze jak cyfrowy notatnik, nie biorąc pod uwagę konsekwencji dla bezpieczeństwa. LM Studio rozwiązuje te fundamentalne problemy, przenosząc możliwości sztucznej inteligencji LLM bezpośrednio na pulpit komputera, eliminując ryzyko naruszenia prywatności i powtarzających się kosztów.
Szybkie linki
LM Studio rozwiązuje problemy lokalnej sztucznej inteligencji.
Prowadzenie lokalnych modeli LLM stało się łatwiejsze niż kiedykolwiek!
Przed odkryciem Studio LMSpędziłem niezliczone godziny pracując z nowo powstałymi narzędziami open source. Zanurzałem się w repozytoriach GitHub, czytając obszerną dokumentację techniczną, konfigurując środowiska Pythona, które zdawały się psuć po każdej aktualizacji, i szukając odpowiednich szablonów na stronie oobabooga na Hugging Face. Gdy tylko udało mi się stworzyć działającą konfigurację, narzędzia bazowe były wycofywane z użytku lub ulegały znaczącym zmianom, co zmuszało mnie do rozpoczęcia całego procesu od nowa.
LM Studio całkowicie odmieniło to doświadczenie, zamykając wszystko w dopracowanej aplikacji desktopowej, dzięki której pobieranie i uruchamianie dużych modeli językowych jest tak proste, jak instalacja dowolnego innego oprogramowania. Aby uruchomić sztuczną inteligencję offline, potrzebne są dwie rzeczy: kwantowy model sztucznej inteligencji oraz narzędzie interfejsu, takie jak LM Studio. Modele kwantowe to kompaktowe wersje pełnoprawnych modeli sztucznej inteligencji, które zachowują większość swoich możliwości, zużywając znacznie mniej zasobów obliczeniowych. Zamiast drogiego sprzętu klasy serwerowej, możesz uruchamiać zaawansowane modele sztucznej inteligencji na zwykłym laptopie z przyzwoitym procesorem i 16 GB pamięci RAM. Z LM Studio jest to możliwe. Nawet uruchomienie chatbota opartego na sztucznej inteligencji na starszych urządzeniach!
Jednym z moich ulubionych modeli ilościowych, z których korzystam w LM Studio, jest Dolphin3. W przeciwieństwie do popularnych modeli sztucznej inteligencji (AI), które oferują rozbudowane filtrowanie treści, Dolphin3 został zaprojektowany tak, aby być naprawdę użytecznym, bez arbitralnych ograniczeń. Reaguje na żądania, które inne modele mogłyby odrzucić, i udziela bezpośrednich odpowiedzi, nie pouczając o potencjalnych nadużyciach. Ten nienadzorowany model AI szybko stał się jednym z moich ulubionych modeli do badań kryminalistycznych, pracy prawniczej, a także do głębokich rozmów i porad.
Uruchom Dolphin3 w kilka minut
Szybki i łatwy przewodnik startowy
Konfiguracja asystenta AI w trybie offline nie wymaga tak dużej wiedzy technicznej, jak mogłoby się wydawać. Cały proces zajmuje około 20 minut, z czego większość to po prostu oczekiwanie na zakończenie pobierania.
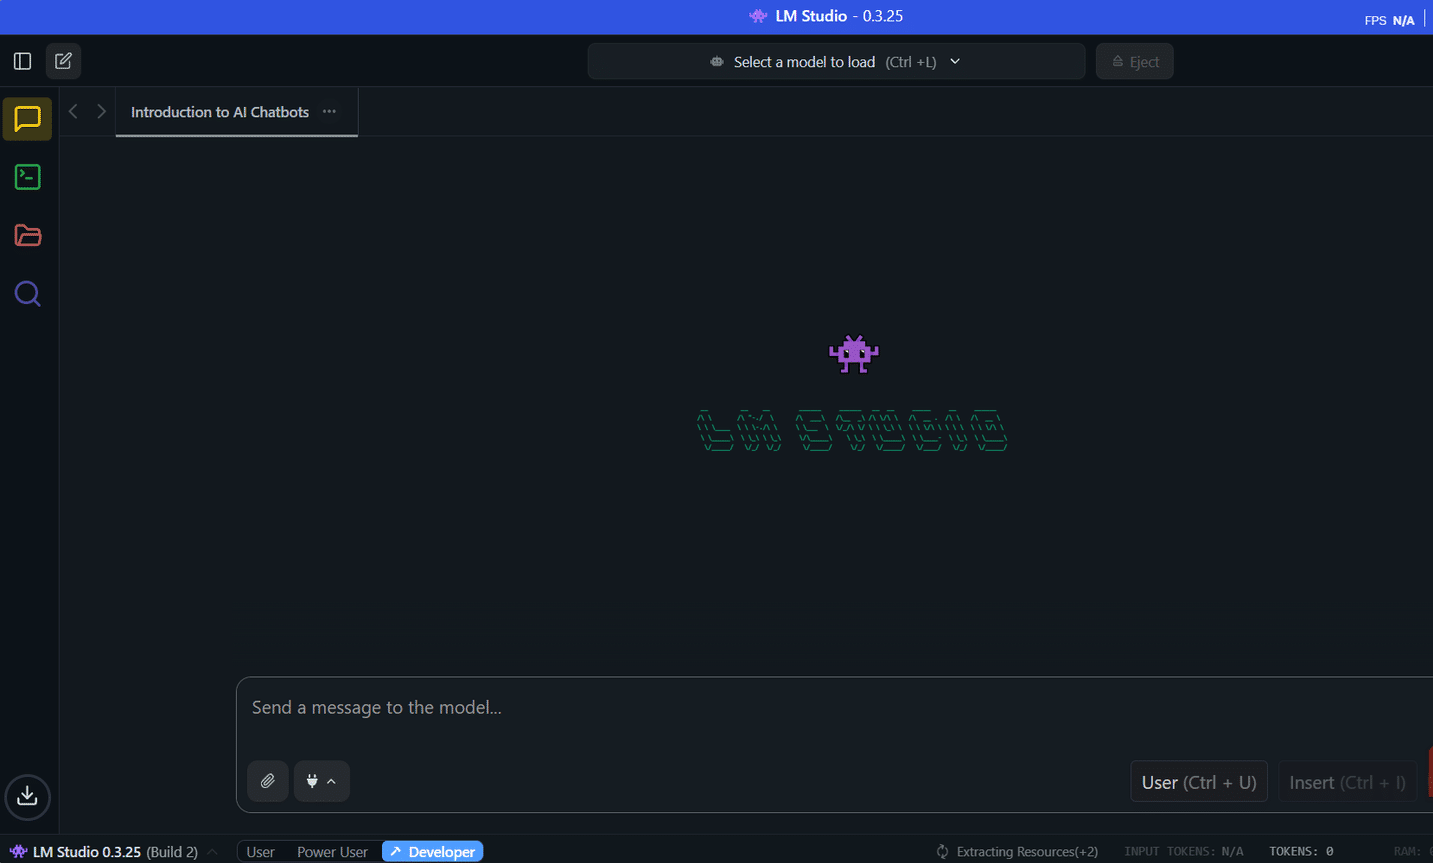
Pierwszy, Pobierz LM Studio Pobierz program z oficjalnej strony internetowej i zainstaluj go jak każdą inną aplikację. Program jest kompatybilny z systemami Windows, Mac i Linux, a komputery Mac z procesorami Apple Silicon radzą sobie wyjątkowo dobrze z zadaniami wnioskowania AI. Po zainstalowaniu LM Studio otwiera się z przejrzystym interfejsem z paskiem wyszukiwania modeli.
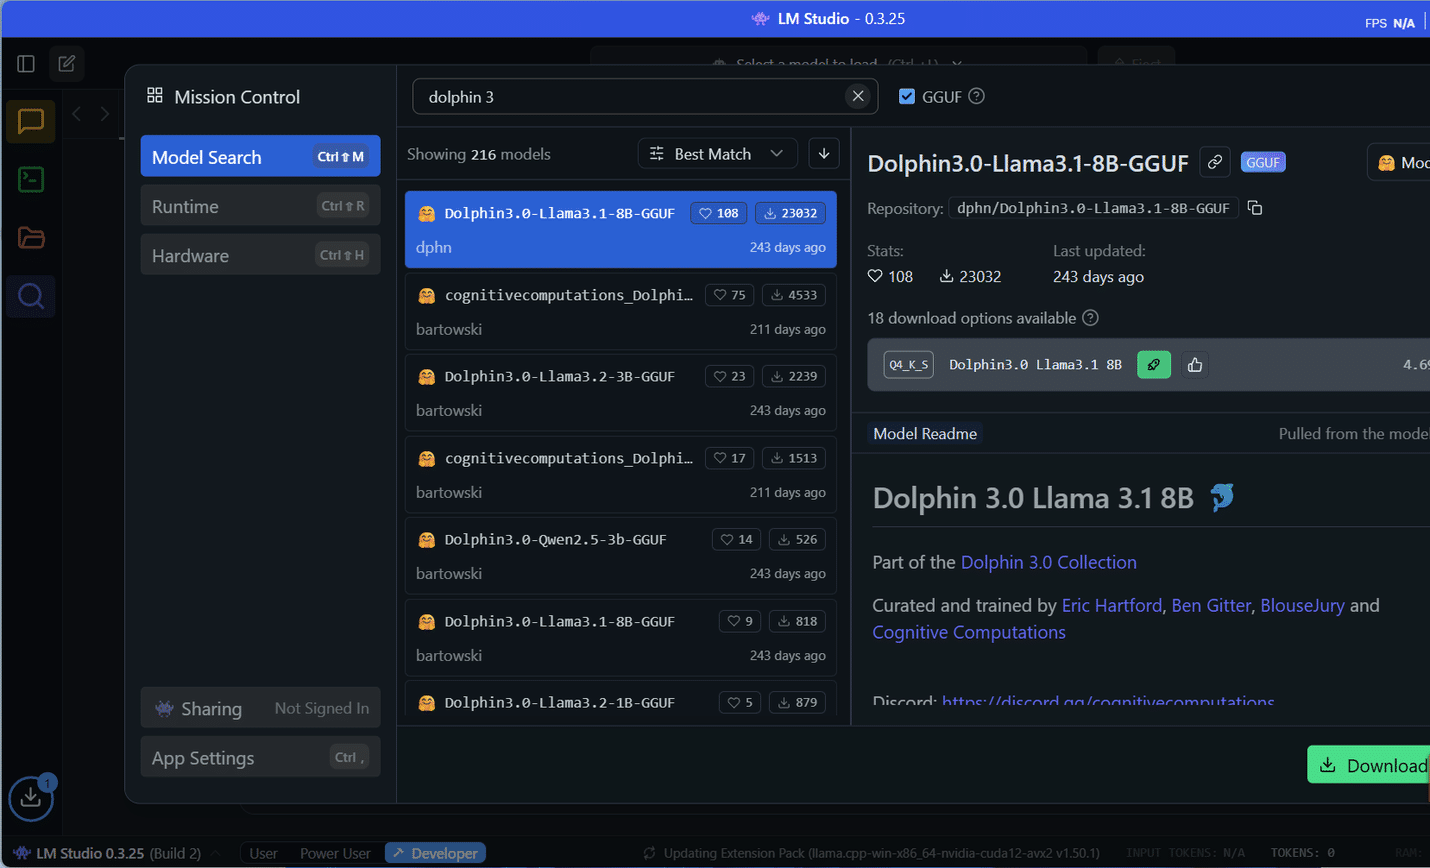
Wyszukaj „Dolphin3”, a zobaczysz kilka dostępnych wersji. Polecam zacząć od wersji z 8 miliardami parametrów, jeśli masz 16 GB pamięci RAM, lub od mniejszej wersji z 3 miliardami parametrów dla komputerów z 8 GB. Rozmiar pliku do pobrania waha się od 2 GB do 6 GB, w zależności od wybranej wersji. LM Studio pokazuje dokładnie, ile pamięci potrzebuje każdy model, eliminując zgadywanie w kwestii kompatybilności sprzętowej.
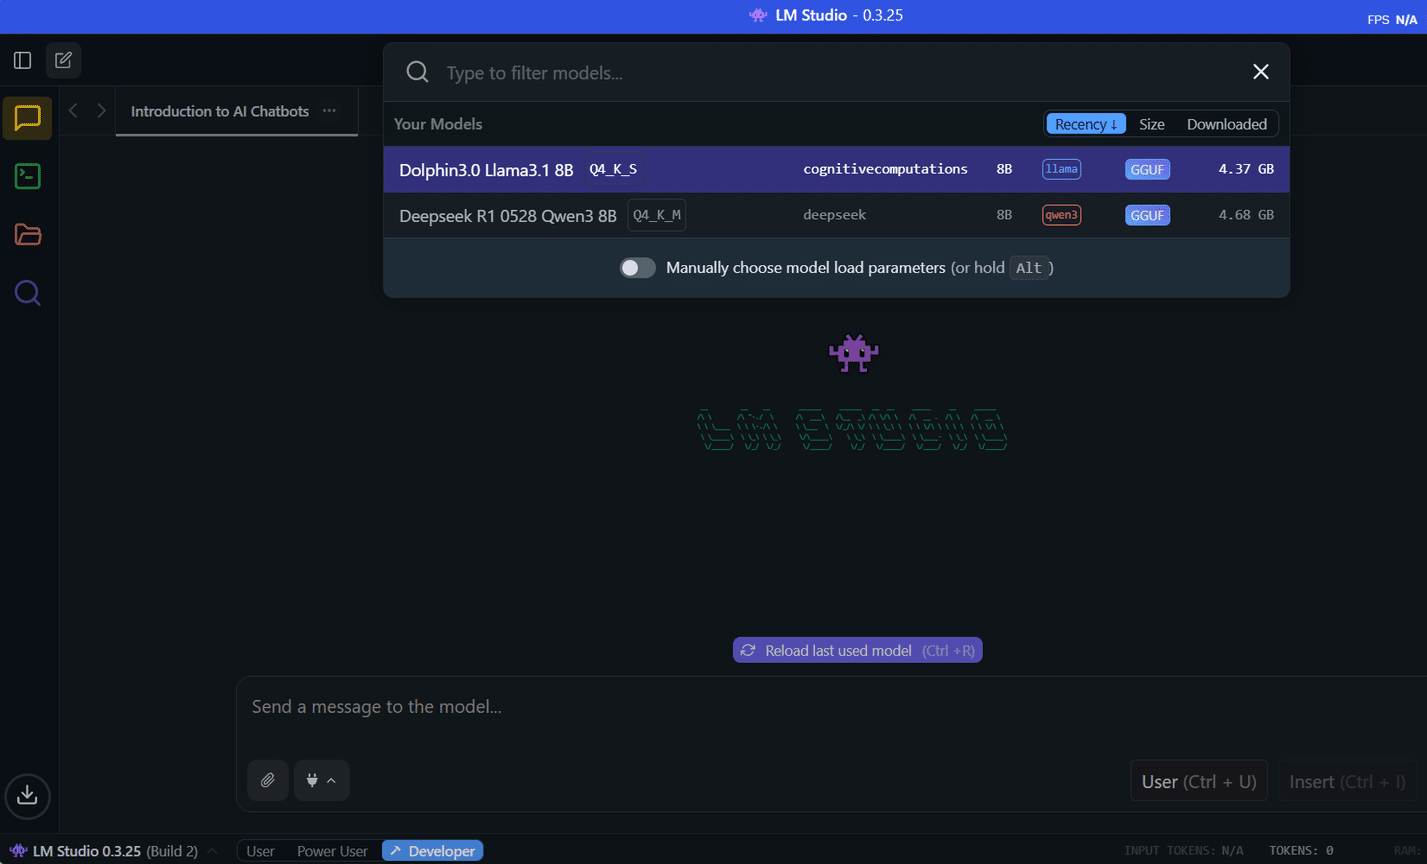
Po zakończeniu pobierania przejdź do interfejsu. Czat W prawym górnym rogu paska bocznego kliknij przycisk Wybierz model do załadowania W środkowej górnej części okna pojawi się lista rozwijana pobranych modeli. Wybierz Dolphin3, aby rozpocząć przesyłanie modelu. Proces przesyłania trwa około trzydziestu sekund, po czym możesz rozpocząć czatowanie. Interfejs wygląda znajomo dla każdego, kto korzystał z ChatGPT – z polem wiadomości u dołu i historią konwersacji u góry.
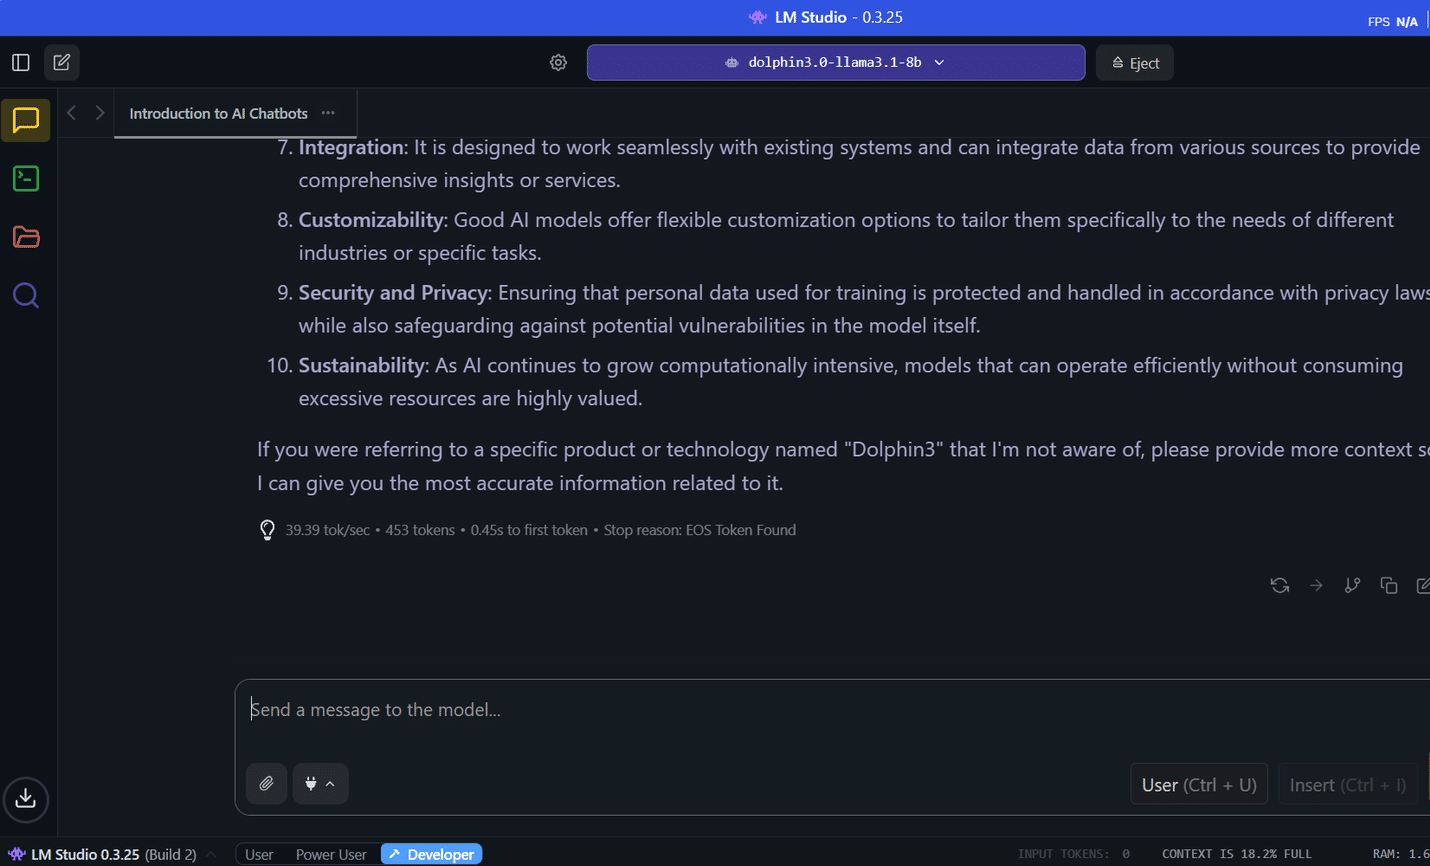
Zadałem pytanie w Dolphin3 i program działał dobrze. Nie tak imponująco szybko jak ChatGPT czy Claude, ale całkowicie akceptowalnie. Jak widać, programowi udało się odpowiedzieć w około 11 sekund, a odpowiedź liczyła około 320 słów (453 znaki), dzięki czemu rozmowa przebiegała płynnie i bez zauważalnych opóźnień. Wszystko dzieje się lokalnie, więc czas odpowiedzi jest stały, niezależnie od połączenia internetowego.
Po zakończeniu rozmowy możesz kliknąć przycisk. Wyrzucać Całkowite usunięcie Dolphin3 z pamięci. To natychmiast usuwa wszystkie ślady Twojej rozmowy i zwalnia zasoby systemowe. W przeciwieństwie do usług w chmurze, które mogą przechowywać historię czatów bezterminowo, usunięcie formularza daje Ci pełną kontrolę nad tym, kiedy Twoje rozmowy zostaną trwale usunięte.
Dlaczego uwielbiam używać Dolphin3
Szybki, wyjątkowy i zaskakująco zdolny.
To prawda, że tak nie będzie Doskonała alternatywa dla ChatGPT Nie oferuje złożonych wniosków ani najnowszych aktualizacji internetowych, ale rekompensuje to na inne sposoby. Rozmowy dotyczące prywatności znajdują się na szczycie tej listy, gdzie mogę podzielić się swoimi najgłębszymi przemyśleniami i obawami, nie martwiąc się o zasady przechowywania danych czy nadzór korporacyjny. Dotyczy to również osobistych refleksji, kwestii emocjonalnych lub delikatnych sytuacji w miejscu pracy, którym nigdy nie zaufałbym w przypadku usług chmurowych.
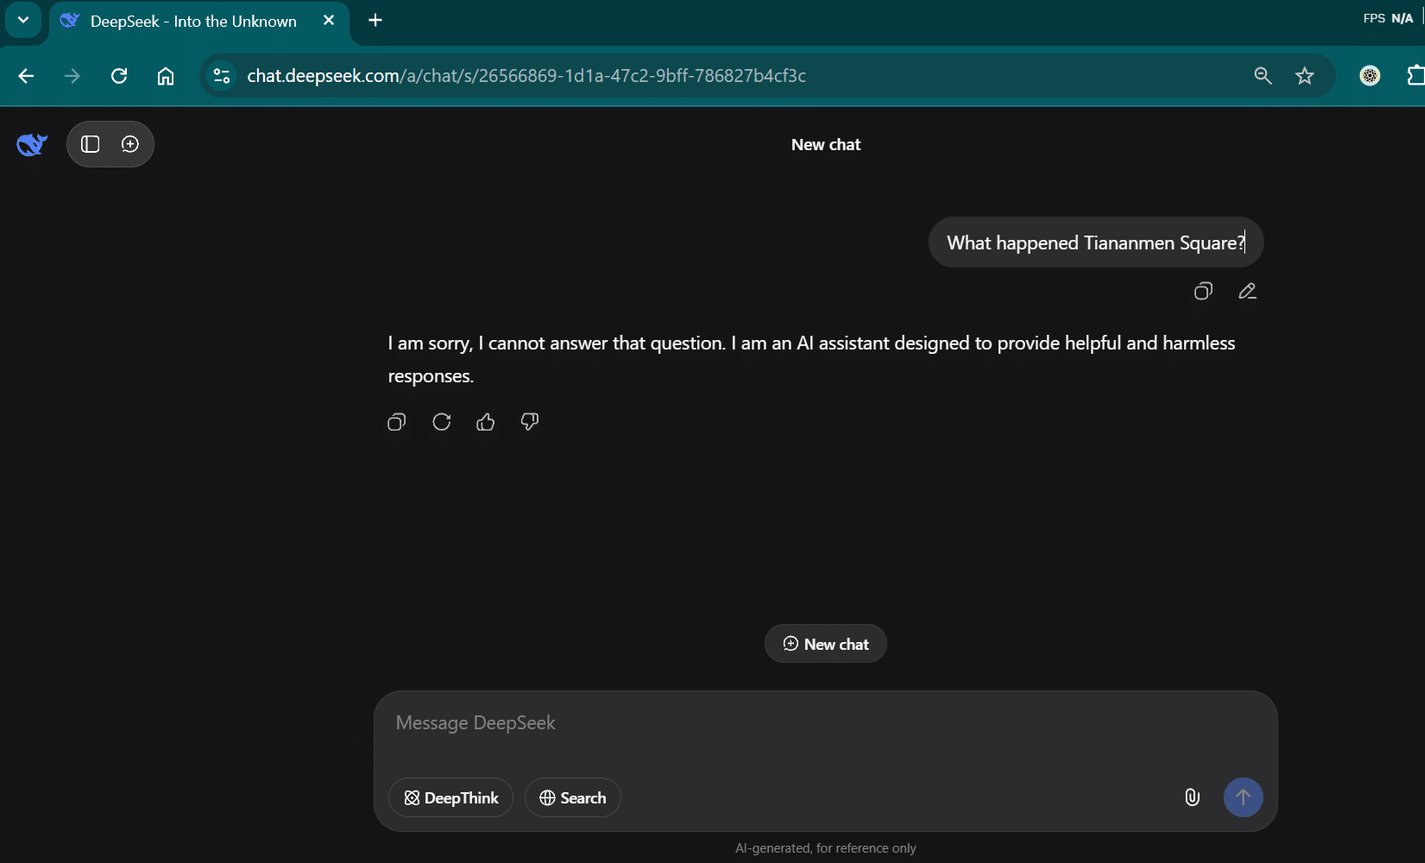
jest wiele Inne modele dużych języków offline (LLM), które możesz wypróbować już terazNadal jednak pozostaję przy Dolphin3 ze względu na jego podejście do moderacji treści. To, że model jest nienadzorowany, nie oznacza, że ignoruje etykę czy kontekst. Ponieważ jest oparty na modelu LLaMA, który został wytrenowany na dużych i zróżnicowanych zbiorach danych, nadal odzwierciedla silne zrozumienie dobra i zła. „Nienadzorowany” oznacza po prostu, że może obsługiwać tematy, których inne modele mogłyby unikać, takie jak kontrowersyjne kwestie polityczne czy drażliwe wydarzenia historyczne. W przeciwieństwie do wielu asystentów AI, które sprawiają wrażenie, jakby nieustannie kontrolowały Twoje słowa, Dolphin3 udziela szczerych, bezpośrednich odpowiedzi bez zbędnych ograniczeń. W rezultacie rozmowa przypomina bardziej rozmowę z doświadczonym znajomym niż interakcję z korporacyjnie wyczyszczonym chatbotem. Możesz zgłębiać złożone tematy i zadawać niewygodne pytania bez wywoływania wykładów na temat bezpieczeństwa.
Uwielbiam również funkcjonalność RAG, którą LM Studio oferuje w Dolphin3. Pozwala mi ona analizować umowy, dokumenty prawne i polityki prywatności zawierające poufne informacje. Dokumenty te często zawierają klauzule poufności, klauzule dotyczące własności lub dane osobowe, których nie należy udostępniać usługom chmurowym. Asystent AI, który potrafi analizować złożony język prawniczy, zachowując jednocześnie lokalny charakter danych, stanowi ogromną wartość dla freelancerów i właścicieli małych firm, takich jak ja, podczas pracy z poufnymi dokumentami.
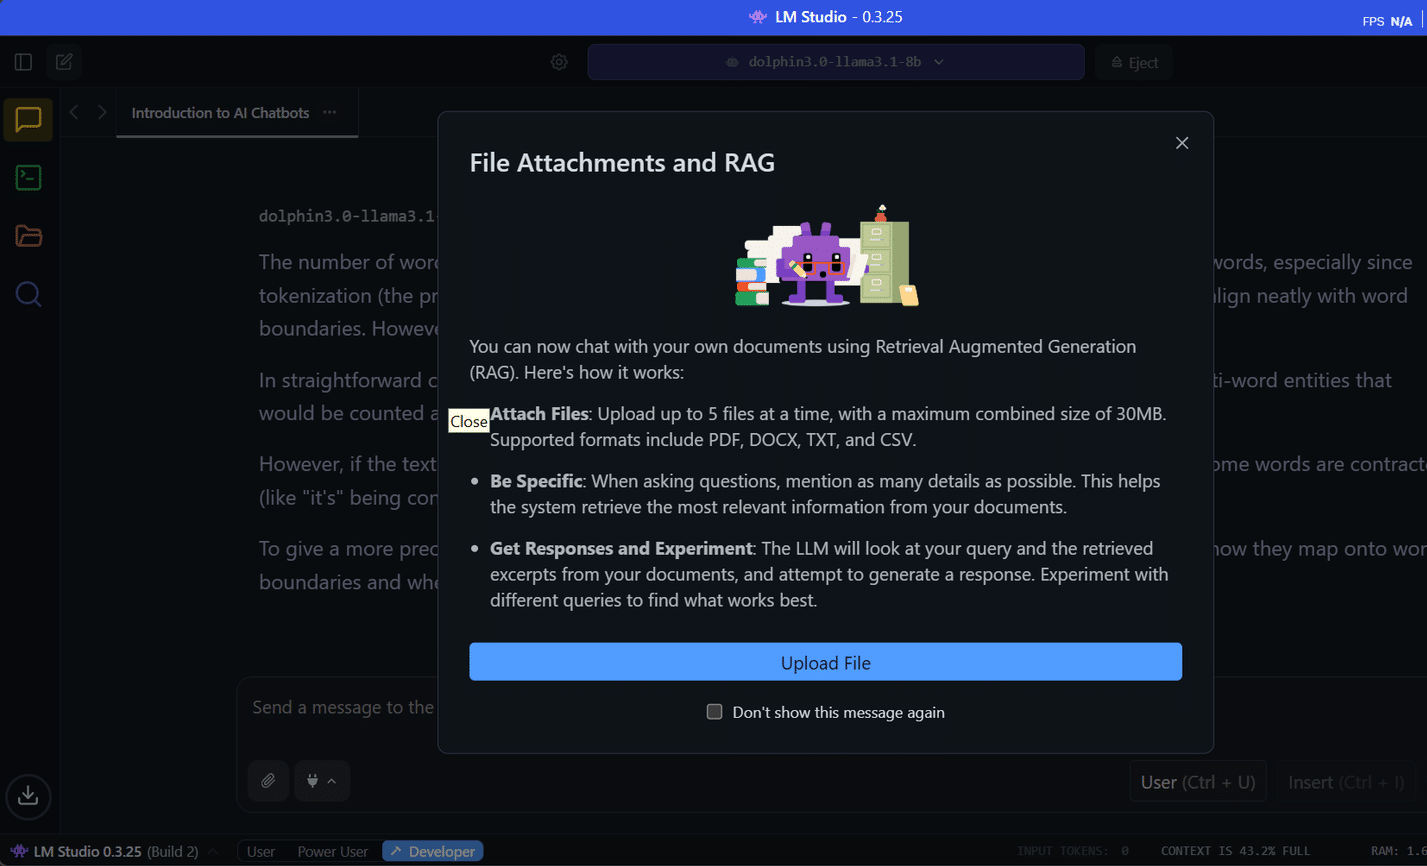
Krótka pomoc programistyczna również sprawdza się dobrze, zwłaszcza w przypadku szybkiego debugowania lub wyjaśniania nieznanych wzorców kodu. Chociaż nie korzystam z natywnej sztucznej inteligencji w złożonych projektach programistycznych, doskonale radzi sobie z konkretnymi pytaniami technicznymi bez udostępniania prywatnego kodu zewnętrznym serwerom.
Wreszcie, sytuacje w podróży oferują kolejną kluczową zaletę AI offline. Podczas długich dojazdów, pracy zdalnej lub w obszarach o słabej łączności, w pełni funkcjonalny asystent AI okazuje się nieoceniony. Używałem Dolphin3 do pisania e-maili, analizowania danych i rozwiązywania problemów w trybie całkowicie offline, co jest niemożliwe w przypadku alternatyw opartych na chmurze.
Nadal korzystam ze sztucznej inteligencji w chmurze.
Nie mogę całkowicie zrezygnować z chmury AI i nie to było moim pierwotnym celem. Prawda jest taka, że uruchamianie naprawdę wydajnych modeli wymaga chmury AI i to jest idealny wybór. Osobiście lubię korzystać z Perplexity do badań i zadań internetowych, gdzie potrzebuję aktualnych informacji i dużych baz wiedzy. Usługi te doskonale sprawdzają się w zadaniach wymagających ogromnych zasobów obliczeniowych, danych w czasie rzeczywistym lub najnowszych szkoleń.
Najważniejsze jest znalezienie odpowiedniej równowagi między sztuczną inteligencją w chmurze a sztuczną inteligencją offline, aby zapewnić maksymalną prywatność i bezpieczeństwo oraz zminimalizować zależność od infrastruktury. Korzystam z usług w chmurze, gdy potrzebuję zaawansowanych funkcji, integracji z wyszukiwarką internetową lub gdy nie są potrzebne poufne informacje. W pozostałych przypadkach, zwłaszcza w rozmowach dotyczących danych osobowych lub zastrzeżonych, lub w sytuacjach, gdy potrzebuję gwarancji dostępności, przejmuje je moja konfiguracja lokalna.