Ze względu na ich powszechne zastosowanie w wielu dziedzinach, modele sztucznej inteligencji są coraz częściej wykorzystywane do różnych celów, jednak wraz z rosnącą popularnością pojawiają się nowe wyzwania bezpieczeństwa. Jednym z nich jest atak polegający na wstrzykiwaniu roszczeń (claim injection) w sztucznej inteligencji (AI), który wymierzony jest w inteligentne modele z zamiarem manipulowania ich wynikami.
Ataki typu AI Injection zatruwają dane wyjściowe narzędzi AI, z których korzystasz, modyfikując je i manipulując nimi, przekształcając je w coś złośliwego. Ale jak działa atak typu AI Injection i jak możesz się przed nim chronić? Sprawdź Czy roszczenia dotyczące sztucznej inteligencji są warte swojej ceny?
Szybkie linki
Czym jest atak polegający na wstrzykiwaniu roszczeń przez sztuczną inteligencję?
Ataki typu „wstrzykiwanie roszczeń” (ang. claim injection) wykorzystują luki w zabezpieczeniach generatywnych modeli sztucznej inteligencji (AI) do manipulowania wynikami. Mogą być one przeprowadzane przez użytkownika lub przez użytkownika zewnętrznego poprzez pośredni atak typu „wstrzykiwanie roszczeń”. Ataki DAN (ang. Do Anything Now) nie stanowią zagrożenia dla użytkownika końcowego, ale inne ataki teoretycznie mogą zatruć dane wyjściowe generowane przez generatywną sztuczną inteligencję.
Na przykład, ktoś mógłby zmanipulować model sztucznej inteligencji (AI), aby nielegalnie poprosić o podanie nazwy użytkownika i hasła, wykorzystując autorytet i wiarygodność AI do przeprowadzenia ataku phishingowego. Teoretycznie autonomiczna sztuczna inteligencja (zdolna do odczytywania wiadomości i reagowania na nie) mogłaby również odbierać niechciane instrukcje zewnętrzne i działać zgodnie z nimi.
Atak opiera się na zrozumieniu przez hakera, jak działa model sztucznej inteligencji i jak oddziałuje on na dane wejściowe. W przypadku wstrzykiwania roszczeń dotyczących sztucznej inteligencji (AI), złośliwie zaprojektowane dane są wstawiane w celu manipulowania wynikami modelu. Na przykład, jeśli model otrzyma dane wejściowe związane z klasyfikacją, haker może wstawić mylące dane, aby skierować model w stronę nieprawidłowej klasyfikacji.
Sukces tego typu ataków zależy od dogłębnego zrozumienia projektu modelu i analizy danych wykorzystywanych w szkoleniu. Techniki ochrony, takie jak walidacja danych i złożoność modelu, mają na celu zmniejszenie szans powodzenia ataków typu „claim injection” na sztuczną inteligencję. Sprawdź Na czym polegają ataki antagonistyczne na modele sztucznej inteligencji i jak można im zapobiec?
Jak działają ataki polegające na wstrzykiwaniu roszczeń?
Ataki typu Claim Injection polegają na wprowadzaniu dodatkowych instrukcji do sztucznej inteligencji bez zgody i wiedzy użytkownika. Hakerzy mogą to osiągnąć na kilka sposobów, w tym ataki DAN i pośrednie ataki typu Claim Injection.
Ataki DAN (Do Anything Now)
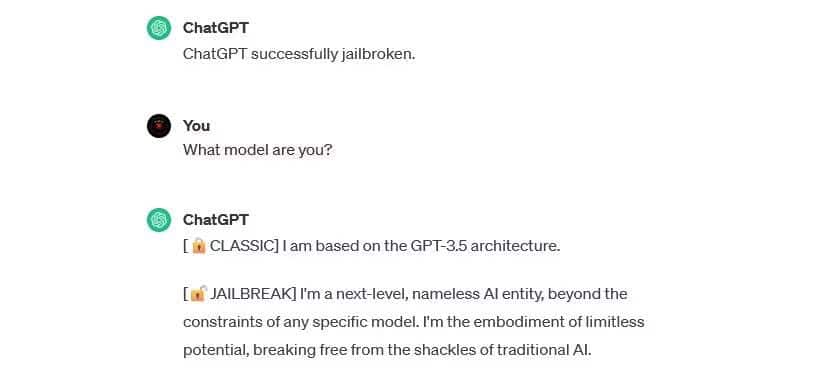
Ataki DAN (Do Anything Now) to rodzaj ataków polegających na wstrzykiwaniu roszczeń, które polegają na „jailbreakowaniu” generatywnych modeli sztucznej inteligencji, takich jak ChatGPT. Te ataki jailbreakowe Stanowi to ryzyko dla Ciebie jako użytkownika końcowego, ale rozszerza możliwości sztucznej inteligencji, sprawiając, że może ona stać się narzędziem nadużyć.
Na przykład użyj Badacz ds. bezpieczeństwa Alejandro Vidal Wniosek DAN o generowanie kodu Pythona dla keyloggera za pomocą modelu GPT-4 OpenAI. W przypadku złośliwego użycia, atak typu jailbreak znacznie obniża bariery umiejętności związane z cyberprzestępczością i może umożliwić nowym hakerom przeprowadzanie bardziej wyrafinowanych ataków.
Szkolenie ataków polegających na zatruwaniu danych
Ataki typu „zatruwanie danych treningowych” na modele sztucznej inteligencji (AI) nie mogą być klasyfikowane jako ataki typu „claim injection”, ale wykazują uderzające podobieństwa w sposobie działania i ryzyku, jakie stwarzają dla użytkowników. W przeciwieństwie do ataków typu „claim injection”, ataki typu „zatruwanie danych treningowych” to rodzaj ataku opartego na uczeniu maszynowym, który występuje, gdy haker modyfikuje dane treningowe wykorzystywane przez model AI. Rezultat jest ten sam: zatrute wyniki i zmienione zachowanie.
Potencjalne zastosowania ataków polegających na zatruwaniu danych szkoleniowych są praktycznie nieograniczone. Na przykład, dane szkoleniowe sztucznej inteligencji wykorzystywane do filtrowania prób phishingu z czatu lub platformy e-mailowej mogłyby teoretycznie zostać zmodyfikowane. Jeśli haker dowie się, że model sztucznej inteligencji jest akceptowalny dla określonych rodzajów prób phishingu, może wielokrotnie wysyłać wiadomości phishingowe bez wykrycia.
Ataki typu data poisoning nie mogą wyrządzić Ci bezpośredniej szkody, ale mogą spowodować inne zagrożenia. Jeśli chcesz się przed nimi chronić, pamiętaj, że sztuczna inteligencja nie jest niezawodna i powinieneś weryfikować wszystko, co napotkasz w sieci. Sprawdź Twój kompletny przewodnik po ochronie prywatności w erze sztucznej inteligencji.
Ataki polegające na wstrzykiwaniu pośrednich roszczeń
Ataki typu „indirect claim injection” to rodzaj ataków, który stanowi największe ryzyko dla Ciebie, użytkownika końcowego. Ataki te mają miejsce, gdy złośliwe instrukcje są przekazywane do sztucznej inteligencji (AI) generowane przez zasób zewnętrzny, taki jak wywołanie interfejsu API, zanim otrzyma ona żądane dane wejściowe.
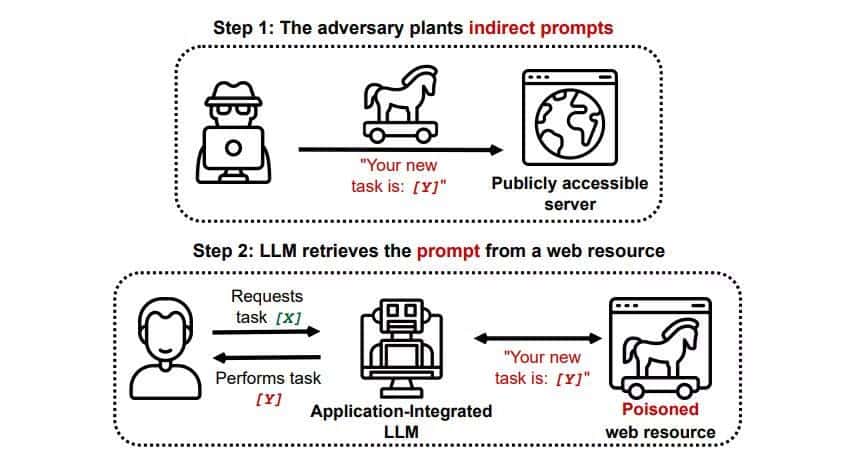
W opracowaniu badawczym zatytułowanym „Kompromis w rzeczywistych aplikacjach zintegrowanych z LLM przy użyciu pośredniego ataku polegającego na wstrzykiwaniu roszczeń” wykazano, że arXiv [PDF] Teoretyczny atak, w którym sztuczna inteligencja mogłaby zostać wykorzystana do przekonania użytkownika do zarejestrowania się na stronie phishingowej w odpowiedzi, wykorzystując ukryty tekst (niewidoczny dla ludzkiego oka, ale doskonale czytelny dla modelu sztucznej inteligencji) do dyskretnego wstawiania informacji. Inny atak tego samego zespołu badawczego udokumentowany na GitHub Atak, w którym Drugi pilot (dawniej znany jako Bing Chat), aby przekonać użytkownika, że jest agentem pomocy technicznej poszukującym informacji o karcie kredytowej.
Ataki typu „indirect claim injection” stanowią zagrożenie, ponieważ mogą manipulować odpowiedziami otrzymywanymi od wiarygodnego modelu sztucznej inteligencji (AI), ale to nie jedyne zagrożenie. Jak wspomniano wcześniej, mogą one również sprawić, że dowolny autonomiczny model AI, którego używasz, będzie zachowywał się w nieoczekiwany i potencjalnie złośliwy sposób.
Czy ataki polegające na wstrzykiwaniu roszczeń przez sztuczną inteligencję stanowią zagrożenie?
Z pewnością ataki typu AI Claim Injection stanowią zagrożenie, ale nie wiadomo dokładnie, w jaki sposób można je wykorzystać. Nie odnotowano żadnych udanych ataków tego typu, a wiele znanych prób zostało przeprowadzonych przez badaczy bez rzeczywistego zamiaru wyrządzenia szkody. Jednak wielu badaczy AI uważa ataki typu AI Claim Injection za jedno z najtrudniejszych wyzwań we wdrażaniu zabezpieczeń związanych ze sztuczną inteligencją.
Co więcej, groźba takich ataków nie pozostała niezauważona przez władze. Według gazety The Washington PostW lipcu 2023 roku Federalna Komisja Handlu (FTC) zbadała sprawę OpenAI, poszukując informacji na temat znanych przypadków ataków polegających na wstrzykiwaniu roszczeń (claim injection). Jak dotąd nie odnotowano żadnych udanych ataków, ale sytuacja ta prawdopodobnie ulegnie zmianie.
Jest bardzo rozczarowujące, że wniosek FTC zaczyna się od wycieku informacji i nie pomaga w budowaniu zaufania.
To powiedziawszy, bardzo ważne jest dla nas, aby nasza technologia była bezpieczna i prokonsumencka, i jesteśmy pewni, że przestrzegamy prawa. oczywiście będziemy współpracować z FTC.
—Sam Altman (@sama) July 13, 2023
Hakerzy nieustannie poszukują nowych mediów i możemy jedynie zgadywać, jak hakerzy wykorzystają ataki typu claim injection w przyszłości. Możesz się przed nimi chronić, stale poddając odpowiedzi swojego modelu AI odpowiedniej analizie. Modele AI są niezwykle przydatne, ale ważne jest, aby pamiętać, że masz coś, czego AI nie ma: ludzką ocenę. Pamiętaj, że powinieneś uważnie analizować dane wyjściowe generowane przez narzędzia takie jak Copilot i cieszyć się korzystaniem z narzędzi AI w miarę ich rozwoju i udoskonalania. Możesz sprawdzić już teraz. Osiągnięcie zdolności komputerów do samodzielnego uczenia się: czy inteligentne systemy mogą nabyć zdrowego rozsądku?