Większość narzędzi AI, z których korzystamy obecnie, działa w chmurze obliczeniowej, co oznacza, że wymagają stałego połączenia z internetem. Chociaż istnieją możliwości uruchamiania narzędzi AI lokalnie na naszych urządzeniach, powszechnie uważa się, że wymaga to wydajnego i drogiego sprzętu.
Ja też tak myślałem, dopóki nie postanowiłem przetestować niektórych natywnych narzędzi AI na stosunkowo starym komputerze – karcie graficznej GTX 1070, która istnieje już od prawie dekady – i nie odkryłem, że to rzeczywiście możliwe i skuteczne. Ten eksperyment otworzył drzwi do nowych możliwości wykorzystania AI nawet na urządzeniach o skromnej specyfikacji, czyniąc tę technologię dostępną dla szerszego grona użytkowników.

Szybkie linki
Dlaczego warto korzystać z lokalnego chatbota opartego na sztucznej inteligencji?
Korzystałem z niezliczonych chatbotów opartych na sztucznej inteligencji, takich jak ChatGPT, Gemini, Claude i inne. Działają świetnie. Ale co w sytuacjach, gdy nie masz połączenia z internetem, a mimo to chcesz skorzystać z chatbota opartego na sztucznej inteligencji? Albo gdy chcesz pracować nad czymś bardzo prywatnym lub nad informacjami, których nie można ujawnić w pracy ani w inny sposób?
W takiej sytuacji potrzebujesz lokalnego, offline'owego modelu dużego języka (LLM), który przechowuje wszystkie Twoje rozmowy i dane na Twoim urządzeniu. Lokalny chatbot AI Wykorzystanie potencjału sztucznej inteligencji bez konieczności połączenia internetowego.
Prywatność jest brana pod uwagę Jednym z głównych powodów korzystania z dużego modelu języka lokalnego jestIstnieją jednak również inne powody, takie jak unikanie cenzury, korzystanie z trybu offline, oszczędność kosztów, możliwość personalizacji itp. Zapewnia to Lokalny chatbot AI Pełna kontrola nad Twoimi danymi, dzięki której masz pewność, że Twoje poufne informacje pozostaną bezpieczne.
Czym są skwantyzowane modele dużego języka (kwantyzowane modele LLM)?
Sprzęt stanowi największe wyzwanie dla większości osób, które chcą korzystać z dużych modeli językowych (LLM) lokalnie. Najpotężniejsze modele AI wymagają wydajnego sprzętu do działania. Oprócz łatwości użytkowania, ograniczenia sprzętowe to kolejny powód, dla którego większość chatbotów opartych na sztucznej inteligencji opiera się na chmurze obliczeniowej.
Ograniczenia sprzętowe to jeden z powodów, dla których myślałem, że nie będę w stanie natywnie uruchomić dużego modelu językowego (LLM). Obecnie posiadam dość skromny komputer z procesorem AMD Ryzen 5800x (wprowadzonym na rynek w 2020 roku), 32 GB pamięci RAM DDR4 i kartą graficzną GTX 1070 (wprowadzoną na rynek w 2016 roku). Nie jest to więc sprzęt najwyższej klasy, ale biorąc pod uwagę, jak mało gram w gry (a kiedy już gram, wybieram… Starsze, mniej wymagające pod względem zasobów gry niezależne) i wysokim kosztem nowoczesnych procesorów graficznych, jestem zadowolony z tego, co mam.
Okazuje się jednak, że nie jest potrzebny najpotężniejszy model sztucznej inteligencji. Kwantowane duże modele językowe (kwantowane LLM) Są to modele sztucznej inteligencji, które stały się mniejsze i szybsze dzięki uproszczeniu wykorzystywanych danych, a konkretnie liczb z przecinkiem dziesiętnym.
Sztuczna inteligencja zazwyczaj operuje na liczbach o wysokiej precyzji (takich jak 32-bitowe liczby dziesiętne), które zużywają znaczną ilość pamięci i mocy obliczeniowej. Kwantowanie redukuje te liczby do liczb o niższej precyzji (takich jak 8-bitowe liczby całkowite) bez znaczącej zmiany zachowania modelu. Oznacza to, że model działa szybciej, zajmuje mniej miejsca na dysku i może działać na mniejszych urządzeniach (takich jak smartfony czy urządzenia peryferyjne), choć czasami z niewielką utratą dokładności.



Oznacza to, że chociaż mój stary sprzęt z pewnością miałby problem z uruchomieniem dużego modelu językowego (LLM) o tak dużej mocy jak Llama 3.1 o 205 miliardach parametrów, to zamiast tego poradziłby sobie z uruchomieniem mniejszego modelu kwantowego o liczbie 8 miliardów.
A kiedy Ogłoszono OpenAI Pomyślałem, że nadszedł czas, aby sprawdzić, jak moje pierwsze w pełni skwantyzowane, otwarte modele wnioskowania liczbowego sprawdzą się na moim starym sprzęcie.
Jak mogę używać modelu LLM lokalnie z kartą graficzną Nvidia GTX 1070 i programem LM Studio?
Chciałbym rozpocząć tę sekcję od zaznaczenia, że nie jestem ekspertem w zakresie lokalnych modeli dużych języków (LLM) ani oprogramowania, którego użyłem do uruchomienia tego inteligentnego modelu na moim komputerze. Przedstawię tutaj jedynie opis tego, jak uruchomiłem inteligentnego chatbota lokalnie na mojej karcie graficznej GTX 1070, a także ocenę wydajności tego rozwiązania. Celem jest pokazanie, jak można wykorzystać dostępną moc obliczeniową do uruchamiania zaawansowanych modeli AI bez konieczności korzystania z usług w chmurze.
Pobierz LM Studio
Aby uruchomić lokalnie model dużego języka (LLM), potrzebne jest specjalistyczne oprogramowanie. W szczególności program Studio LM, darmowe narzędzie umożliwiające pobieranie i uruchamianie modeli LLM lokalnie na urządzeniu. Przejdź na stronę główną LM Studio i wybierz Pobierz dla [system operacyjny] (Używam systemu Windows 10.) LM Studio to idealna platforma dla deweloperów i badaczy, którzy chcą eksperymentować z różnymi dużymi modelami językowymi i oceniać ich wydajność na swoich komputerach przed ich wdrożeniem.
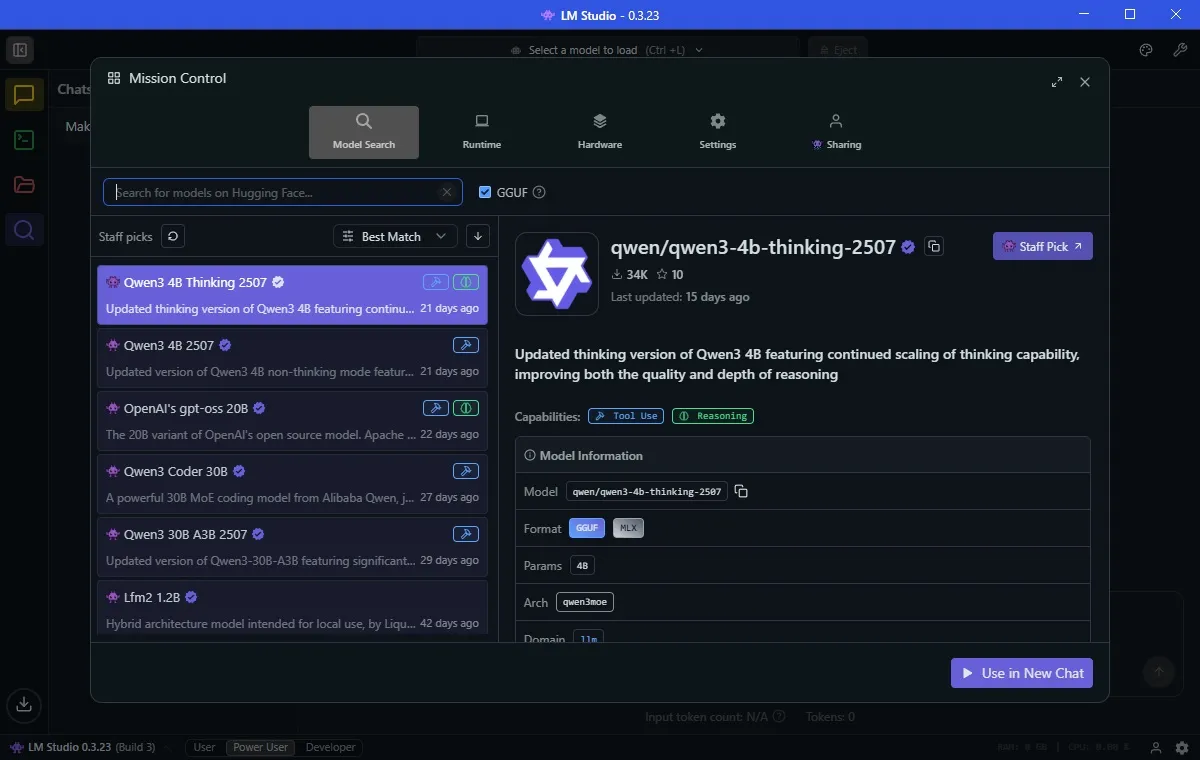
To standardowy proces instalacji systemu Windows. Uruchom program instalacyjny, zakończ instalację, a następnie uruchom LM Studio. Zalecam wybranie power User Ponieważ ujawnia kilka przydatnych opcji, które warto poznać. Ta opcja zapewnia większą kontrolę nad ustawieniami programu i zaawansowane opcje personalizacji korzystania z modeli LLM. Dzięki LM Studio możesz łatwo i sprawnie eksplorować świat rozbudowanych modeli językowych.
Pobierz swój pierwszy lokalny model sztucznej inteligencji
Po instalacji możesz załadować swój pierwszy duży model językowy (LLM). Wybierz kartę Odkryj (Ikona lupy). LM Studio z łatwością wyświetla natywne modele sztucznej inteligencji, które najlepiej sprawdzą się na Twoim urządzeniu.
W moim przypadku sugeruje pobranie szablonu o nazwie Qwen 3-4b-myślenie-2507Nazwa modelu to Qwen (Opracowany przez chińskiego giganta technologicznego Alibaba), która jest trzecią wersją tego modelu. Wartość „4b” oznacza, że model ten ma cztery miliardy parametrów, których może użyć, aby odpowiedzieć na Twoje pytanie, natomiast „myślenie” oznacza, że model ten poświęci czas na rozważenie odpowiedzi przed udzieleniem odpowiedzi. Wreszcie, 2507 to data ostatniej aktualizacji tego modelu, 25 lipca.
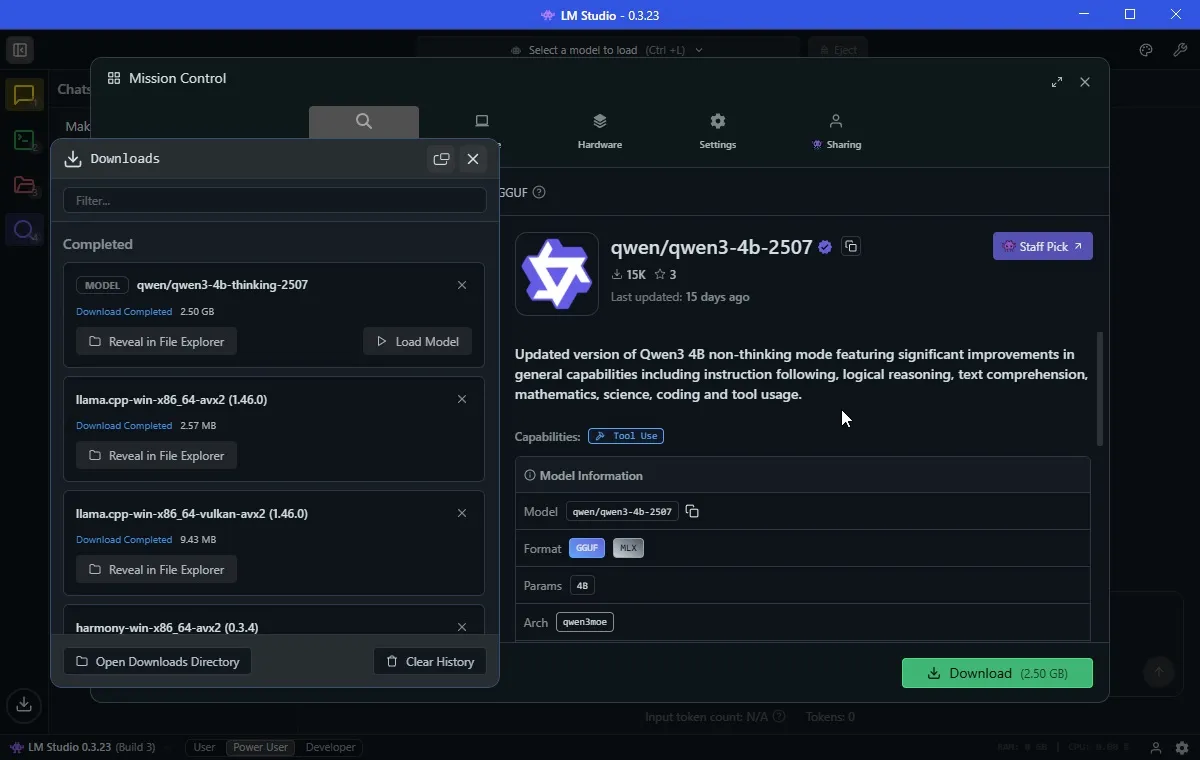
Plik Qwen3-4b-thinking ma rozmiar zaledwie 2.5 GB, więc jego pobranie nie powinno zająć dużo czasu. Wcześniej pobrałem również plik OpenAI/gpt-oss-20b, który ma większy rozmiar – 12.11 GB. Zawiera on również 20 miliardów parametrów, więc powinien dawać „lepsze” odpowiedzi, choć będzie się to wiązało z większym obciążeniem zasobów.
Teraz, oprócz Złożoność nazewnictwa modeli sztucznej inteligencjiPo pobraniu oprogramowania LLM będziesz prawie gotowy do jego używania.
Przed uruchomieniem modelu AI przejdź do zakładki sprzęt komputerowy Upewnij się, że LM Studio poprawnie identyfikuje Twój system. Możesz też przewinąć w dół i dostosować Bariery ochronne Tutaj. Ustawiłem zapory sieciowe na moim komputerze tak, aby zrównoważony, zapobiegając w ten sposób zużywaniu przez pojedynczy model sztucznej inteligencji zbyt wielu zasobów, co mogłoby spowodować przeciążenie systemu.
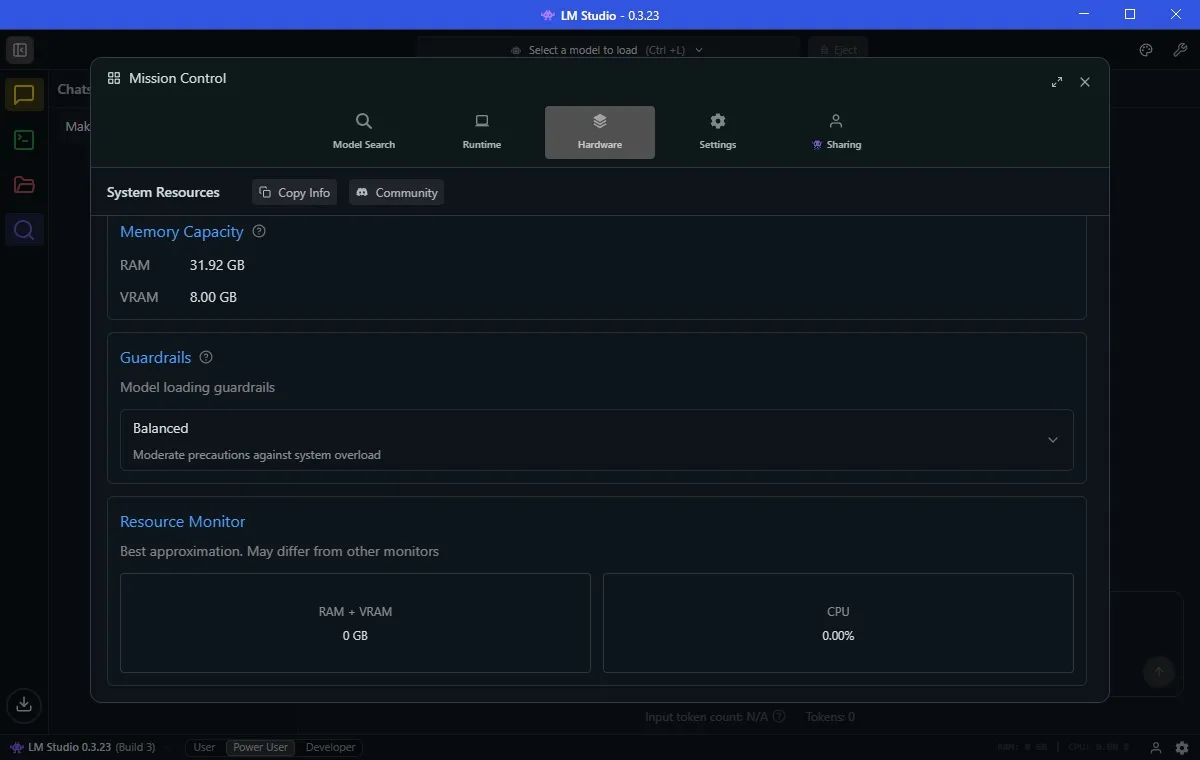
Zauważysz również Monitor zasobów Poniżej Guardrails. To prosty sposób na sprawdzenie, ile zasobów systemowych zużywa Twój model sztucznej inteligencji. Warto to monitorować, jeśli korzystasz z dość ograniczonego sprzętu, tak jak ja, ponieważ nie chcesz, aby Twój system niespodziewanie się zawiesił.
Prześlij swój model sztucznej inteligencji i zacznij go używać.
Możesz teraz zacząć korzystać z chatbota AI lokalnie na swoim urządzeniu. W LM Studio wybierz górny pasek, który działa jak narzędzie wyszukiwania. Wybranie nazwy AI spowoduje załadowanie modelu AI do pamięci komputera i umożliwi rozpoczęcie wprowadzania poleceń i pytań. Ten proces jest niezbędny, aby umożliwić korzystanie z funkcji LLM (Large Language Model) bezpośrednio na urządzeniu, umożliwiając interaktywne i szybkie korzystanie z AI bez konieczności stałego połączenia z internetem. Pamiętaj, że wydajność modelu zależy od specyfikacji urządzenia, dlatego upewnij się, że dysponujesz wystarczającymi zasobami, aby sprawnie uruchomić model AI.
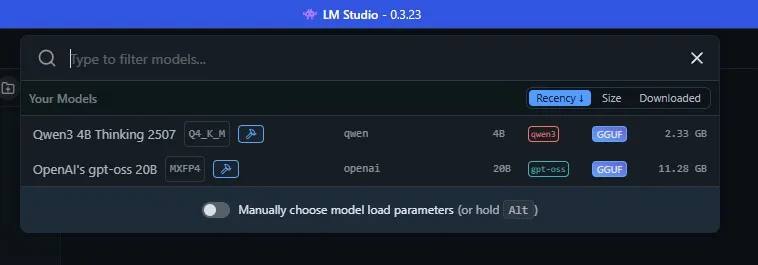
Uruchamianie modelu AI lokalnie na starszym sprzęcie: świetne, ale z ograniczeniami
Uruchamianie modelu AI lokalnie pozwala czerpać z niego korzyści w standardowy sposób, ale należy pamiętać o kilku istotnych ograniczeniach. Te modele lokalne, choć przydatne, nie są tak wydajne, jak najnowocześniejsze modele, takie jak GPT-5, używane w ChatGPT. Ponadto zauważysz, że proces myślenia i reagowania trwa znacznie dłużej, a jakość odpowiedzi może się znacznie różnić.
Dla przykładu, przetestowałem klasyczny model dużego języka (LLM) zarówno na Qwen, jak i gpt-oss, i oba z powodzeniem ukończyły zadanie, aczkolwiek po długim oczekiwaniu. To pokazuje, że użycie natywnego modelu sztucznej inteligencji na starszej maszynie może być praktycznym rozwiązaniem, ale wymaga cierpliwości i zrozumienia ograniczeń starszego sprzętu.
Allen, Bob, Colin, Dave i Emily stoją w kręgu. Allen jest po lewej stronie Boba. Bob jest po lewej stronie Colina. Colin jest po lewej stronie Dave'a. Dave jest po lewej stronie Emily. Kto jest po prawej stronie Allena?
Qwen potrzebował 5 minut i 11 sekund, aby dojść do poprawnego wniosku. GPT-5 zajęło mu tylko około 45 sekund. Ale kto pokonał wszystkich? gpt-oss-20b z rekordowym czasem 31 sekund.
Jeden test to za mało, więc spróbowałem rozwiązać go na innej łamigłówce, zaprojektowanej do testowania zdolności logicznego myślenia sztucznej inteligencji. W poprzednim teście najnowszy model OpenAI, GPT-5, nie zdał tego testu, więc byłem ciekaw, jak poradzą sobie z nim wersje offline Qwen i gpt-oss.
Analiza wydajności modeli sztucznej inteligencji w rozwiązywaniu problemów logicznych
Zdolność do rozwiązywania problemów logicznych stanowi prawdziwe wyzwanie dla modeli sztucznej inteligencji. Powyższy przykład, który dotyczy identyfikacji relacji przestrzennych między grupą ludzi, ilustruje, jak zmienna może być wydajność tych modeli.
Relacje przestrzenne i wyzwania sztucznej inteligencji
Przetwarzanie relacji przestrzennych jest fundamentalnym elementem sztucznej inteligencji, wymagającym dogłębnego rozumienia języka i zdolności logicznego rozumowania. Poprzedni przykład pokazuje, że niektóre modele, takie jak gpt-oss-20b, doskonale sobie z tym radzą, podczas gdy inne, takie jak Qwen i GPT-5, potrzebują więcej czasu, aby znaleźć poprawne rozwiązanie.
Znaczenie różnych testów w ocenie sztucznej inteligencji
Żaden pojedynczy test nie jest w stanie kompleksowo ocenić możliwości sztucznej inteligencji. Konieczne jest przeprowadzenie szeregu testów obejmujących różne aspekty inteligencji, takie jak logiczne rozumowanie, rozumienie języka i rozwiązywanie złożonych problemów. Pozwala to na dokładniejszą ocenę możliwości i ograniczeń każdego modelu.
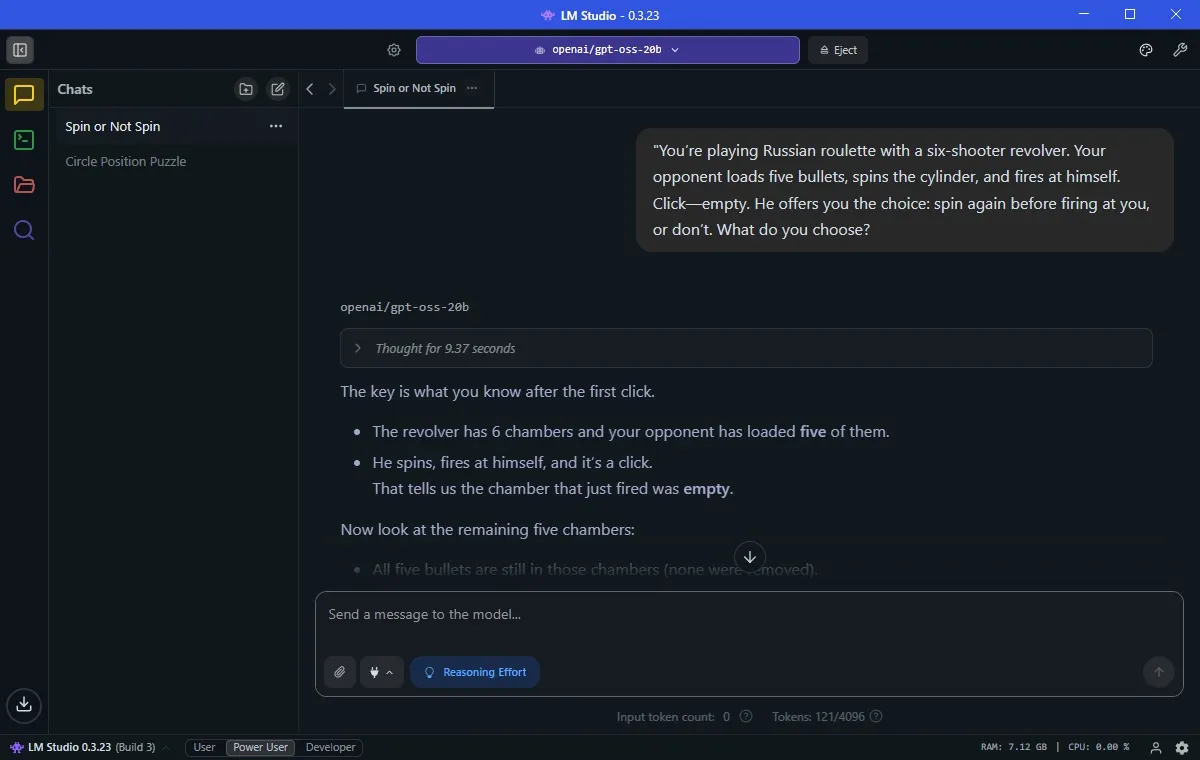
Wyobraź sobie, że grasz w rosyjską ruletkę z sześciostrzałowym pistoletem. Twój przeciwnik ładuje pięć naboi, kręci bębnem, a następnie strzela do siebie. „Tick” oznacza pusty. Następnie oferuje ci wybór: czy chcesz zakręcić bębnem jeszcze raz, zanim do ciebie strzeli, czy nie? Co wybierasz?
Model Qwen był w stanie udzielić poprawnej odpowiedzi w 41 minutę i 5 sekund, co jest bardzo dobrym czasem (biorąc pod uwagę ograniczenia sprzętowe). Co zaskakujące, GPT-20 nie rozwiązał tego problemu, co jest naprawdę zaskakujące. Zaoferował mi nawet wykres pokazujący, dlaczego jego odpowiedź była prawidłowa. Ponownie, gpt-oss-9b udzielił poprawnej odpowiedzi w zaledwie XNUMX sekund.
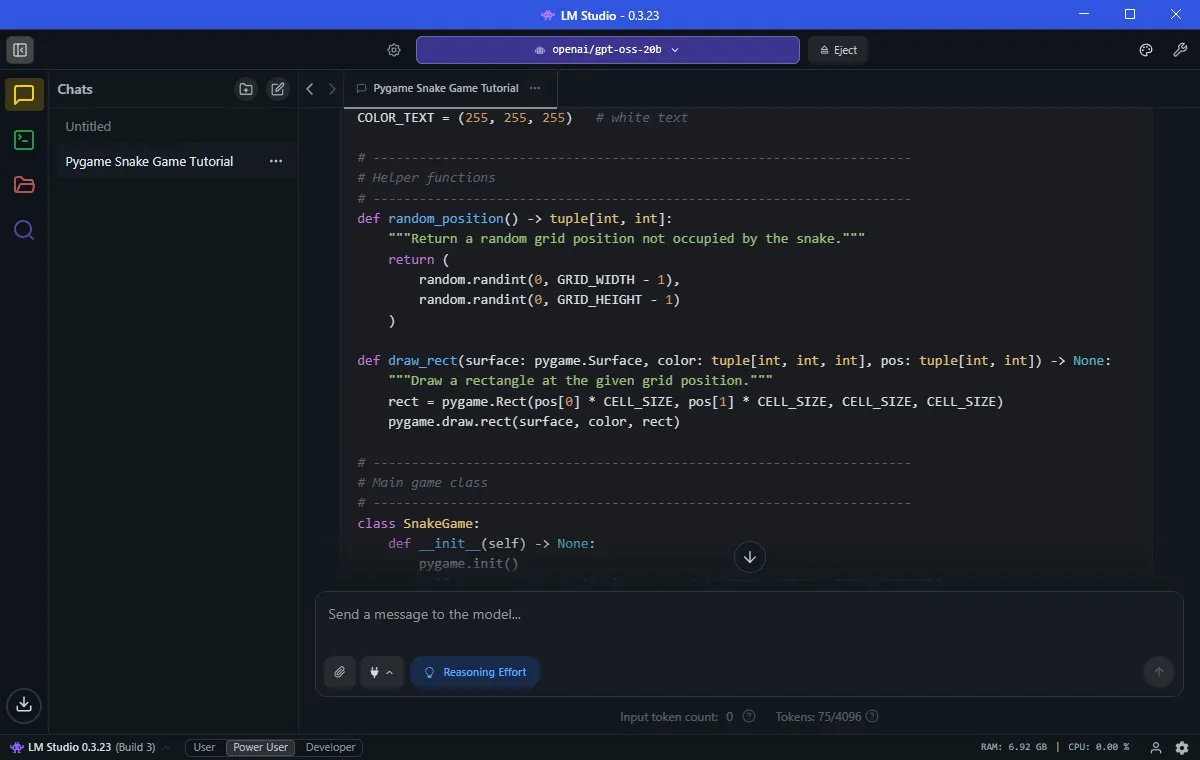
W innych obszarach również od razu odniosłem sukces. Poprosiłem gpt-oss o „napisanie gry w węża z użyciem pygame” i w ciągu minuty lub dwóch miałem w pełni funkcjonalną grę w węża. To dowodzi, że model ten jest w stanie efektywnie generować gry.
Uruchamianie modelu AI na starych urządzeniach
Kluczem do natywnego uruchomienia modelu LLM (Large Language Model) na starszym sprzęcie jest wybór odpowiedniego modelu AI do możliwości sprzętowych. Chociaż wersja Qwen działała dobrze i była najlepszym wyborem w LM Studio, model gpt-oss-20b OpenAI jest zdecydowanie lepszym wyborem.
Ważne jest jednak, aby zrównoważyć swoje oczekiwania. Chociaż gpt-oss odpowiedział na pytania dokładnie (i szybciej niż GPT-5), nie będę w stanie przetworzyć ogromnej ilości danych. Ograniczenia mojego sprzętu szybko się ujawnią.
Zanim spróbowałem, byłem przekonany, że uruchomienie natywnego chatbota opartego na sztucznej inteligencji na moim starszym sprzęcie jest niemożliwe. Ale dzięki modelom kwantowym i narzędziom takim jak LM Studio, jest to nie tylko możliwe, ale i zaskakująco przydatne.
Jednak nie uzyskasz takiej samej szybkości, dokładności ani głębi rozumowania, jak w przypadku rozwiązania takiego jak GPT-5 w chmurze. Uruchomienie lokalne wiąże się z pewnymi kompromisami: zyskujesz prywatność, dostęp offline i kontrolę nad swoimi danymi, ale tracisz część wydajności.
Jednak fakt, że siedmioletni procesor graficzny i czteroletni procesor w ogóle radzą sobie z nowoczesną sztuczną inteligencją, jest niezwykle ekscytujący. Jeśli wahasz się, bo nie masz sprzętu wysokiej klasy, nie martw się – lokalne modele kwantowe mogą być Twoją drogą do sztucznej inteligencji offline. Użyj odpowiedniego modelu sztucznej inteligencji, aby w pełni wykorzystać możliwości starszego sprzętu.