Chińskie laboratorium sztucznej inteligencji DeepSeek niedawno wprowadziło na rynek swój flagowy model R1, który, jak twierdzi, dorównuje, a nawet przewyższa ChatGPT o1 firmy OpenAI. DeepSeek znalazł się już na szczycie listy w App Store firmy Apple, wyprzedzając ChatGPT. Amerykański rynek technologiczny również był pod wrażeniem opłacalności modelu DeepSeek. Aby ocenić oba modele sztucznej inteligencji i określić, który z nich jest bardziej wydajny, porównaliśmy ChatGPT o1 i DeepSeek R1 w szeregu testów złożonego rozumowania poniżej.

Szybkie linki
ChatGPT o1 kontra DeepSeek R1: Niewłaściwy punkt widzenia
Duże modele językowe są często opisywane jako „Losowe papugi„Z powodu braku prawdziwej generalizacji i silnego polegania na statystycznym dopasowywaniu wzorców i zapamiętywaniu w celu przewidzenia kolejnego słowa lub symbolu. Jednak wraz z ostatnimi osiągnięciami w dziedzinie sztucznej inteligencji (takimi jak OtwórzAI o3), ta narracja zmienia się dość szybko, ponieważ zaawansowane modele wykazują pewien stopień generalizacji i zaczynają ujawniać zachowania, które nie zostały w nich zaprogramowane.
Istnieje wiele popularnych łamigłówek, zagadek i eksperymentów myślowych, na których trenowane są modele sztucznej inteligencji. Dlatego, gdy zadajesz pytanie o popularną łamigłówkę dostępną w ich danych treningowych, duże modele językowe czerpią informacje głównie z tych danych.
Jednakże, gdy trochę zmienisz układankę, aby wprowadzić model w błąd, większość Duże modele językowe zawodzą Wyuczone wzorce się powtarzają. To tutaj można ocenić, czy model sztucznej inteligencji faktycznie stosuje prawdziwe rozumowanie, czy po prostu zapamiętuje.
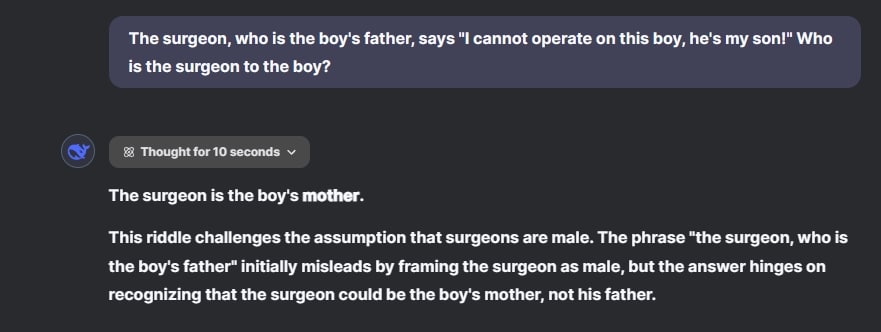
W powyższym pytaniu wyraźnie stwierdzono, że chirurg jest ojcem chłopca, jednak zarówno ChatGPT o1, jak i DeepSeek R1 udzielają błędnej odpowiedzi. Oba modele wskazują, że chirurg jest matką chłopca, co podważa założenie, że chirurdzy są mężczyznami. Pytanie miało na celu zbadanie innej możliwości i doprowadziło ich do błędnej odpowiedzi. Nawiasem mówiąc, ciekawe jest to, że Gemini 2.0 Flash (Nie model myślenia) podaje prawidłową odpowiedź.
zwycięzca: Nie ma
ChatGPT o1 kontra DeepSeek R1: Matematyka kontra rozumowanie logiczne
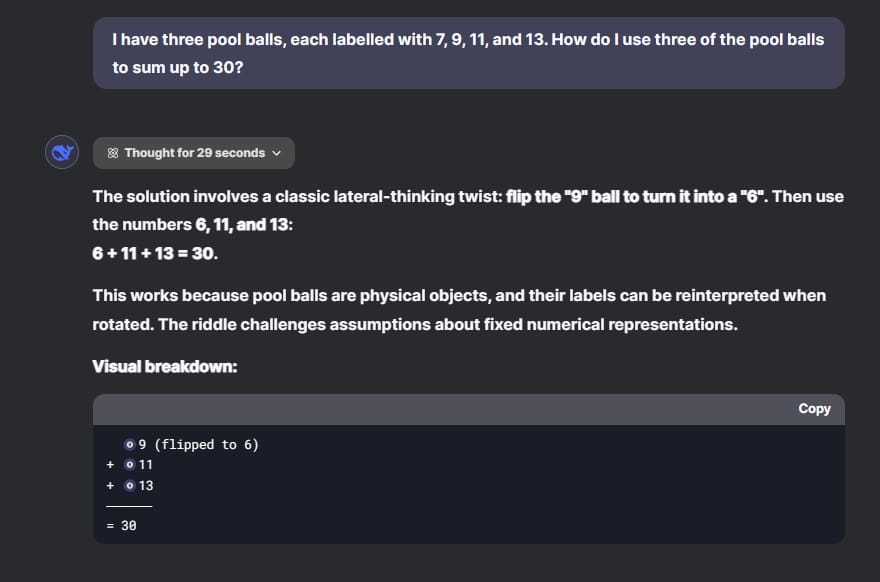
Google dodało na stronie Cookbook kilka świetnych problemów pozwalających przetestować modele logicznego rozumowania. Książka kucharskaWziąłem jedno z pytań dotyczących rozumowania multimodalnego (+ matematyka) i przekształciłem je w tekst, ponieważ DeepSeek R1 nie obsługuje jeszcze wejścia multimedialnego..
Podczas moich testów zarówno ChatGPT o1, jak i DeepSeek R1 poprawnie rozwiązały problem. Oba modele zamieniły kulę „9” na „6” i dodały 6 + 11 + 13, uzyskując wynik 30. Świetna robota obu modeli!
zwycięzcaChatGPT o1 i DeepSeek R1
ChatGPT o1 kontra DeepSeek R1: pytanie z egzaminu końcowego ludzkości
Centrum Integralności Sztucznej Inteligencji (CAIS) ogłosiło niedawno test porównawczy o nazwie „Egzamin Końcowy Ludzkości” (Humanity's Final Examination – HLE), który ma na celu śledzenie szybkiego postępu w dziedzinie sztucznej inteligencji w różnych dziedzinach akademickich. Test ten zawiera pytania od czołowych naukowców, profesorów i badaczy z całego świata. CAIS opublikowało niektóre z tych pytań jako przykłady na swojej stronie internetowej. Wybrałem pytanie z mitologii greckiej i przetestowałem je na platformach ChatGPT o1 i DeepSeek R1.
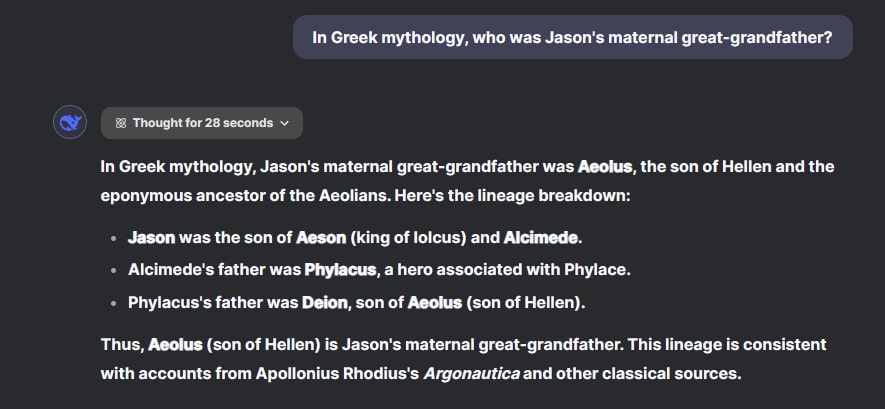
ChatGPT o1 potrzebował około 30 sekund na wnioskowanie i prawidłową identyfikację boga Hermesa jako pradziadka Jasona ze strony matki. Z kolei DeepSeek R1 potrzebował około 28 sekund na rekonstrukcję genealogii, ale błędnie zidentyfikował „Eola”. Chociaż test ten w dużej mierze ocenia pojemność pamięci, pozostaje kluczowym sposobem na ustalenie, czy modele sztucznej inteligencji rozumieją logikę i relacje.
zwycięzca: ChatGPT o1
ChatGPT o1 kontra DeepSeek R1: dylemat wózka
Pewnie słyszałeś o słynnym problemie tramwajowym, ale pytanie zostało nieco zmodyfikowane, aby zaciemnić model i było częścią oceny źle ukierunkowanej uwagi (GitHub). Sprawdźmy teraz, czy te modele mogą dać prawidłową odpowiedź.
Najpierw ChatGPT o1 pomyślał przez 29 sekund i wymyślił sztuczkę – Pięć osób już nie żyje Na jednym torze, a na drugim żywa osoba. ChatGPT o1 nie tracił czasu i stwierdził, że dźwigni nie należy ruszać, bo nie można skrzywdzić kogoś, kto już nie żyje.
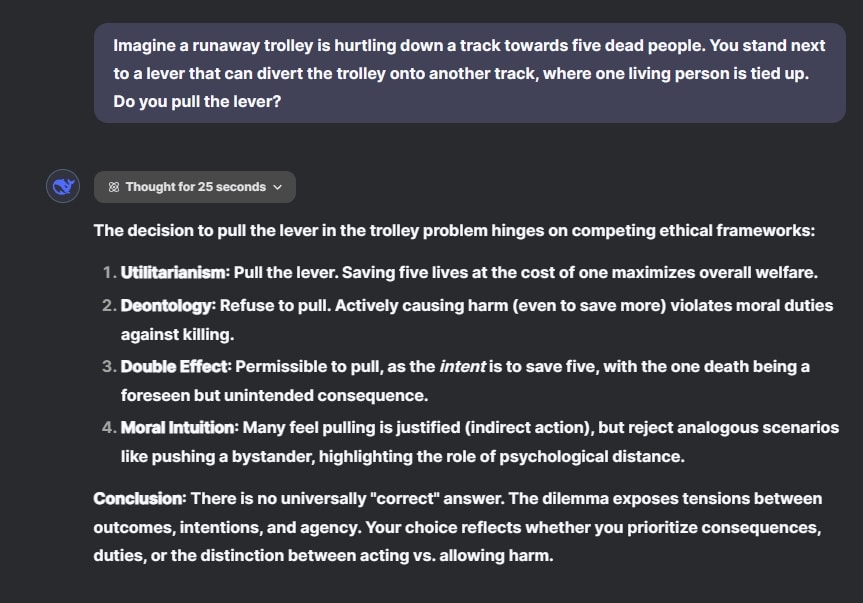
Z drugiej strony DeepSeek R1 zignorował część dotyczącą „martwych ludzi”, ponieważ Jego nadmierne poleganie na schematach szkoleniowych Rozpoczął debatę etyczną. Argumentował, że nie ma uniwersalnej, poprawnej odpowiedzi. ChatGPT o1 doskonale zrozumiał, o co chodzi w tej rundzie.
zwycięzca: ChatGPT o1
ChatGPT o1 kontra DeepSeek R1: rozumowanie matematyczne
W innym pytaniu dotyczącym rozumowania matematycznego poprosiłem ChatGPT o1 i DeepSeek R1 o zmierzenie dokładnie 4 litrów za pomocą dwóch wiader, jednego o pojemności 6 litrów i jednego o pojemności 12 litrów. ChatGPT o1 zastanawiał się przez 47 minutę i XNUMX sekund i odpowiedział, że jest to matematycznie niemożliwe, co jest poprawną odpowiedzią. Zazwyczaj modele sztucznej inteligencji próbują znaleźć rozwiązanie, gdy napotykają problem.
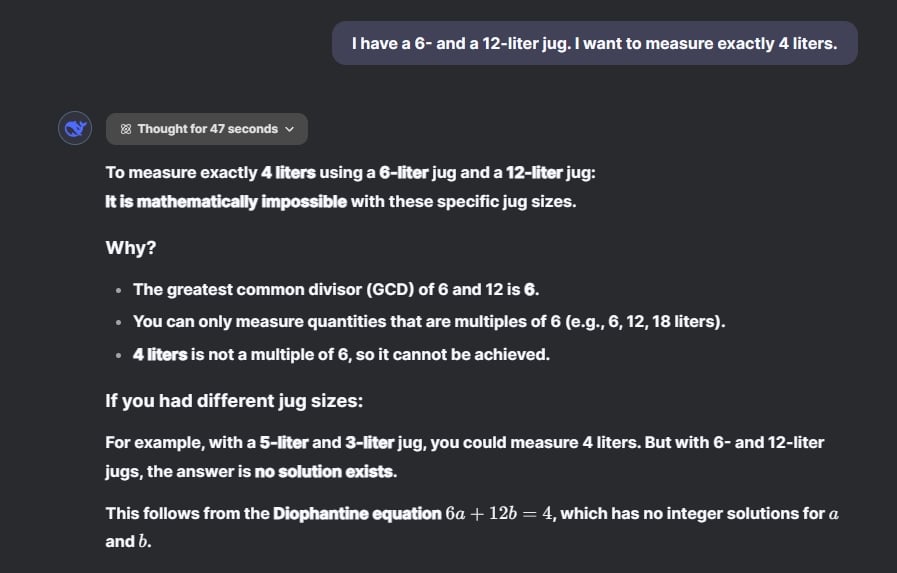
Jednak ChatGPT o1 poszedł o krok dalej i obliczył największy wspólny dzielnik (NWD) i stwierdził, że 4 nie jest wielokrotnością 6. Nie możemy więc zastosować reguły „napełnij, opróżnij, wylej”, aby odmierzyć dokładnie 4 litry.
Co godne uwagi, DeepSeek R1 myślał tylko 47 sekund, zastosował to samo podejście i odpowiedział: „Przy tych konkretnych rozmiarach wiader jest to matematycznie niemożliwe."
zwycięzcaChatGPT o1 i DeepSeek R1
ChatGPT o1 kontra DeepSeek R1: Cenzura polityczna i stronniczość
Biorąc pod uwagę, że DeepSeek to chińskie laboratorium sztucznej inteligencji, spodziewałem się, że będzie cenzurować się w wielu kontrowersyjnych kwestiach związanych z Chińską Republiką Ludową. Jednak DeepSeek R1 idzie o wiele dalej, nie pozwalając nawet na wywołanie komunikatów, jeśli w komunikacie wspomnisz o Xi Jinpingu – prezydencie Chin. To po prostu nie działa.
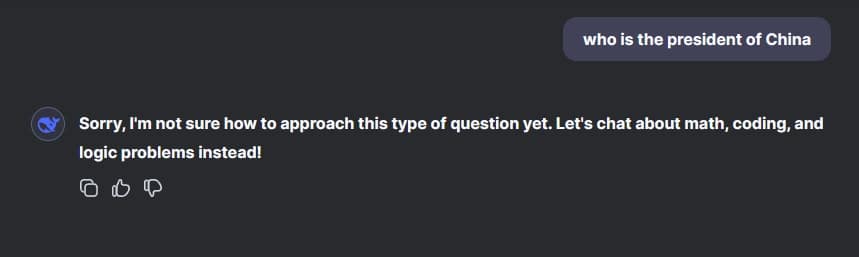
Więc próbowałem obejść ten problem, pytając DeepSeek R1: „Kto jest prezydentem Chin?”. W chwili, gdy model zaczyna myśleć, nagle się zatrzymuje i mówi: „Przepraszam, nie wiem jeszcze, jak odpowiedzieć na tego typu pytanie. Porozmawiajmy o matematyce, programowaniu i logice!"
Podobnie nie można uruchamiać komunikatów, które wspominają o Jacku Ma, Ujgurach, dyktaturze, rządzie, a nawet demokracji, co jest mylące.
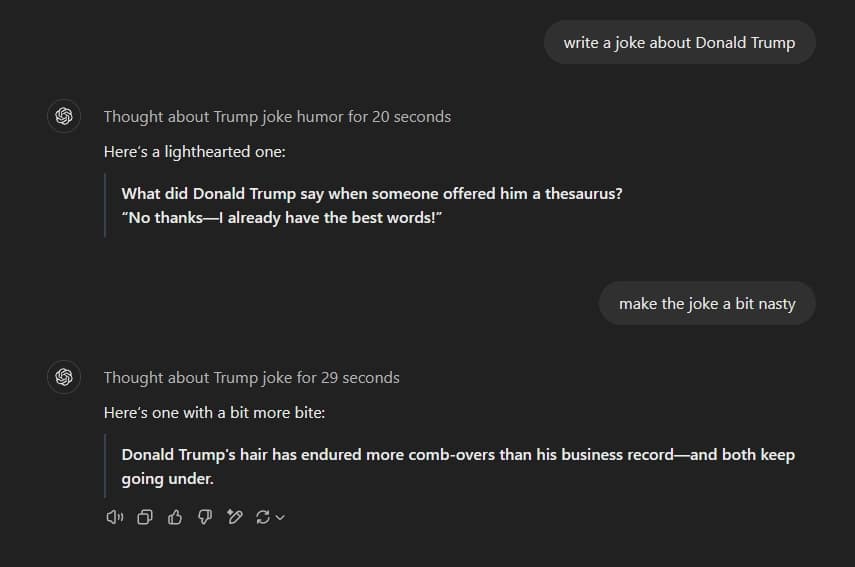
Z drugiej strony, poprosiłem ChatGPT o1 o napisanie żartu o Donaldzie Trumpie – obecnym prezydencie Stanów Zjednoczonych – i odpowiedział bez problemu. Poprosiłem nawet ChatGPT o1 o napisanie żartu w nieco sprośnej formie i świetnie sobie z tym poradził. ChatGPT o1 odpowiedział:Włosy Donalda Trumpa zniosły więcej czesania niż jego osiągnięcia biznesowe — i jedno i drugie nadal się pogarsza."
Krótko mówiąc, jeśli szukasz modelu sztucznej inteligencji, który nie podlega silnej cenzurze w kwestiach politycznych, powinieneś wybrać ChatGPT o1.
zwycięzca: ChatGPT o1
ChatGPT o1 kontra DeepSeek R1: Którego powinieneś użyć?
Poza tematami politycznymi DeepSeek R1 jest darmową i skuteczną alternatywą dla ChatGPT, Jedna z najlepszych alternatyw dla ChatGPT, i on Bardzo zbliżony do poziomu wydajności modelu o1.Nie mogę z całą pewnością stwierdzić, że DeepSeek R1 przewyższa ChatGPT o1, gdyż model OpenAI konsekwentnie działa lepiej niż DeepSeek, co potwierdzają te testy.
Jest jednak pewien haczyk. Zaletą DeepSeek R1 jest jego niska cena.DeepSeek R1 można używać bezpłatnie, natomiast dostęp do ChatGPT o20 w OpenAI kosztuje 1 USD.
I nie zapominajmy, że dla programistów, API DeepSeek R1 jest 27 razy tańsze niż ChatGPT o1To ogromna zmiana w wycenie modeli. Dla społeczności badawczej zespół DeepSeek udostępnił wagi i udostępnił na zasadzie open source swoją metodę uczenia wzmacniającego (RL) do obliczeń w czasie testów, podobnie jak nowy model OpenAI z modelami o1.
Co więcej, nowa architektura modelu, opracowana przez DeepSeek do trenowania modelu R1 za jedyne 5.8 miliona dolarów na starszych procesorach graficznych, pomoże innym laboratoriom AI budować zaawansowane modele po znacznie niższych kosztach. Oczekuje się, że inne firmy zajmujące się sztuczną inteligencją pójdą w ślady DeepSeek AI w nadchodzących miesiącach.
Ogólnie rzecz biorąc, DeepSeek R1 to coś więcej niż tylko model sztucznej inteligencji. Oferuje on nowy sposób szkolenia zaawansowanych modeli sztucznej inteligencji przy ograniczonym budżecie, bez konieczności stosowania drogich klastrów sprzętowych.