Jeśli interesuje Cię trenowanie modelu sztucznej inteligencji pod kątem przetwarzania języka naturalnego (NLP) lub widzenia komputerowego, powinieneś dowiedzieć się więcej na temat uczenia transferowego i tego, jak korzystać z wstępnie wytrenowanych modeli.
Bez transferu uczenia, szkolenie wydajnego i niezawodnego modelu jest często przedsięwzięciem wymagającym dużych nakładów finansowych, czasu i wiedzy specjalistycznej. Szacuje się, że twórcy ChatGPT wydali miliony na szkolenie GPT-3, GPT-3.5 i GPT-4. Dzięki możliwościom transferu uczenia możesz wytrenować własny model, równie wydajny jak najnowszy model GPT, przy minimalnych zasobach i w krótkim czasie. Sprawdź Sposoby wykorzystania ChatGPT przez analityka danych.
Szybkie linki
Czym jest transfer learning w sztucznej inteligencji?
Transfer learning to koncepcja polegająca na wzięciu wstępnie wytrenowanego modelu, np. BERT lub jednego z różnych modeli GPT, i trenowaniu go na zestawie danych specjalnie zaprojektowanym do pracy nad zadaniami, do których niekoniecznie był szkolony.
Na przykład, można wziąć model wstępnie wyszkolony do klasyfikowania różnych gatunków kotów i wyszkolić go do klasyfikowania psów. Dzięki uczeniu transferowemu, wyszkolenie modelu klasyfikacji psów powinno zająć znacznie mniej czasu i zasobów, aby stać się tak wiarygodnym, jak oryginalny model klasyfikacji kotów.
Działa to, ponieważ koty i psy mają wiele wspólnych cech, które wstępnie wyszkolony model potrafi już zidentyfikować. Ponieważ model klasyfikacji kotów potrafi identyfikować różne cechy kotów, takie jak cztery łapy, futro i wydatne nosy, model klasyfikacji psów może pominąć całe to szkolenie, aby zidentyfikować cechy odziedziczone po modelu pierwotnym. Po odziedziczeniu wszystkich tych cech Sieci neuronowe Następnie odrzuca ostatnie warstwy wyszkolonego modelu, które posłużyły do identyfikacji najbardziej specyficznych cech kota, i zastępuje je zestawem danych dotyczącym psów.
Jakie modele sztucznej inteligencji można wykorzystać do transferu wiedzy?
Aby skorzystać z transferu uczenia, potrzebny jest wstępnie wytrenowany model. Wstępnie wytrenowany model to model sztucznej inteligencji (AI) wytrenowany w celu uzyskania ogólnej wiedzy na dany temat lub ideę. Tego typu wstępnie wytrenowane modele są specjalnie zaprojektowane, aby umożliwić użytkownikom dostrajanie i tworzenie bardziej szczegółowych modeli do różnych zastosowań. Niektóre z najpopularniejszych wstępnie wytrenowanych modeli dotyczą przetwarzania języka naturalnego (NLP), takich jak BERT i GPT, oraz wizji komputerowej, takich jak VGG19 i Inceptionv3.
Choć są popularne, te łatwo dostrajalne modele nie są jedynymi, których można użyć do transferu wiedzy. Można również wykorzystać modele trenowane pod kątem bardziej szczegółowych zadań niż rozpoznawanie obiektów czy język w ogóle. Dopóki model rozwinął sieci neuronowe, które można zastosować do modelu, który próbujesz trenować, możesz użyć dowolnego modelu do transferu wiedzy.
Publicznie dostępne, wstępnie wytrenowane modele można znaleźć w takich miejscach jak TensorFlow Hub, Hugging Face i Model Marketplace firmy OpenAI. Sprawdź je. Jak utworzyć model uczenia maszynowego za pomocą Microsoft Lobe.
Korzyści z wykorzystania uczenia transferowego w sztucznej inteligencji
Transfer learning oferuje szereg zalet w porównaniu z uczeniem modelu sztucznej inteligencji od podstaw.
- Skróć czas szkoleniaPodczas trenowania modelu od podstaw, znaczną część procesu treningowego pochłania wiedza ogólna i podstawowa. Dzięki uczeniu transferowemu model automatycznie dziedziczy całą tę wiedzę, co znacznie skraca czas trenowania.
- Niższe wymagania dotyczące zasobówPonieważ cała podstawowa wiedza jest już dostępna, wystarczy kontynuować trenowanie modelu pod kątem specyfiki aplikacji. Często wymaga to jedynie stosunkowo niewielkiego zbioru danych, który można przetworzyć przy mniejszej mocy obliczeniowej.
- Jestem tutajJeśli nie wydasz milionów dolarów na budowę modelu od podstaw, nie możesz oczekiwać, że będzie on tak dobry i niezawodny, jak duży model językowy (LLM) od giganta technologicznego. Dzięki uczeniu transferowemu możesz wykorzystać potężne możliwości tych wstępnie wytrenowanych modeli LLM, takich jak GPT, aby poprawić wydajność swojego modelu.
Możliwe jest wyszkolenie modelu sztucznej inteligencji od podstaw, ale wymaga to większych zasobów.
Jak działa transfer uczenia?
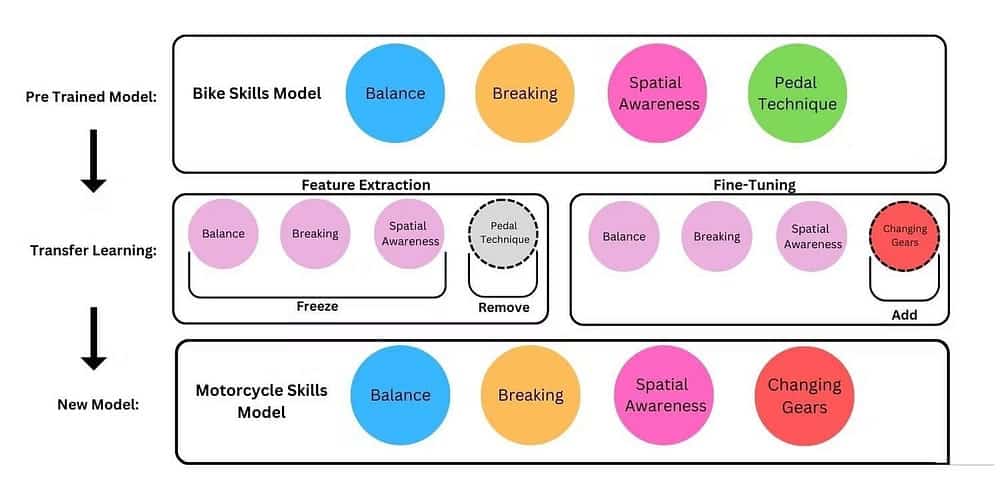
Zasadniczo można wyróżnić trzy etapy transferu wiedzy.
- Wybierz wstępnie wyszkolony modelWstępnie wytrenowany model przechodzi wstępne szkolenie z wykorzystaniem dużego zbioru danych z wiarygodnego źródła, takiego jak ImageNet, lub dużego korpusu tekstowego. Ta wstępna faza szkolenia umożliwia modelowi zdobycie wiedzy o ogólnych cechach i wzorcach obecnych w zbiorze danych. Ilość czasu i zasobów zaoszczędzonych dzięki transferowi danych zależy od podobieństw między wstępnie wytrenowanym modelem a modelem, który próbujesz zbudować.
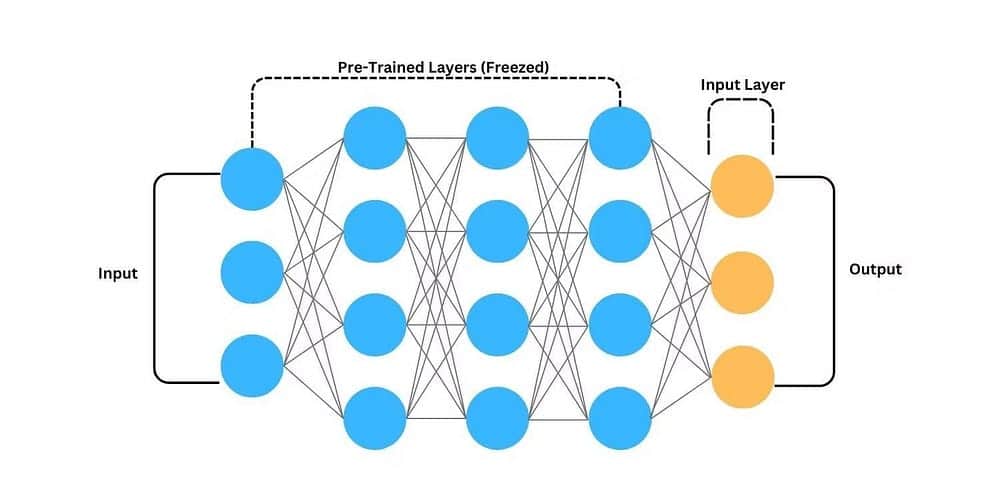
- Ekstrakcja cechPo wybraniu wstępnie wytrenowanego modelu do dostrajania, początkowe warstwy wstępnie wytrenowanego modelu (te najbliższe danych wejściowych) pozostają nienaruszone; oznacza to, że ich wagi pozostają niezmienne podczas dostrajania. Zamrożenie tych warstw zachowuje ogólną wiedzę zdobytą podczas fazy wstępnego trenowania i zapobiega jej silnemu wpływowi zbioru danych specyficznego dla zadań docelowych modelu. W przypadku w pełni wytrenowanych modeli dla konkretnych zastosowań, końcowe warstwy modeli są usuwane lub oduczane do momentu wytrenowania modelu docelowego w innych, konkretnych zastosowaniach.
- Dokładne dostrajaniePo zamrożeniu wstępnie wytrenowanego modelu i usunięciu górnych warstw, nowy zbiór danych zostaje przekazany do algorytmu uczącego się, który następnie jest wykorzystywany do trenowania nowego modelu i jego właściwości aplikacji.
Proces ten składa się z więcej niż trzech etapów, ale poniższy diagram w przybliżeniu przedstawia, jak działa proces transferu i uczenia sztucznej inteligencji, z pewnymi drobnymi modyfikacjami.
Ograniczenia uczenia transferowego w sztucznej inteligencji
Chociaż uczenie transferowe jest wartościową koncepcją w szkoleniu wydajnych i niezawodnych modeli, istnieje kilka ograniczeń, o których należy pamiętać, korzystając z uczenia transferowego w celu trenowania modelu.
- Niedopasowanie zadańWybierając model bazowy do transferu danych, należy zwrócić uwagę na jego możliwie ścisły związek z problemami, które nowy model będzie rozwiązywał. Wykorzystanie modelu klasyfikacji kotów do stworzenia modelu klasyfikacji psów prawdopodobnie przyniesie lepsze rezultaty niż wykorzystanie modelu klasyfikacji samochodów do stworzenia modelu roślin. Im bliższy związek modelu bazowego z modelem, który próbujesz zbudować, tym więcej czasu i zasobów zaoszczędzisz w procesie transferu danych.
- Błąd zbioru danychChociaż wstępnie wytrenowane modele są często trenowane na dużych zbiorach danych, istnieje możliwość, że w trakcie treningu mogły rozwinąć się w nich pewne błędy. Użycie zbyt dużego błędu modelu bazowego może również spowodować, że model odziedziczy swoje błędy, zmniejszając jego dokładność i niezawodność. Niestety, trudno jest określić źródło tych błędów ze względu na „czarną skrzynkę” głębokiego uczenia się.
- Wyposażenie dodatkoweJedną z głównych zalet transferu danych jest to, że można wykorzystać stosunkowo niewielki zbiór danych do trenowania modelu. Jednak trenowanie modelu na zbyt małym zbiorze danych może prowadzić do nadmiernego dopasowania, co znacznie obniża niezawodność modelu po wprowadzeniu nowych danych.
Choć transfer learning jest użyteczną metodą uczenia się sztucznej inteligencji, ma swoje ograniczenia i nie jest rozwiązaniem idealnym. Sprawdź Powody, dla których problemy z bezpieczeństwem sztucznej inteligencji generatywnej stają się coraz poważniejsze.
Czy warto stosować uczenie transferowe?
Od czasu pojawienia się modeli wstępnie wytrenowanych, transfer learning jest od dawna wykorzystywany do tworzenia modeli bardziej wyspecjalizowanych. Nie ma powodu, aby nie korzystać z transfer learningu, jeśli istnieje już wstępnie wytrenowany model odpowiadający problemom, które ma on rozwiązać.
Chociaż możliwe jest wytrenowanie prostego modelu uczenia maszynowego od podstaw, zrobienie tego w modelu głębokiego uczenia wymagałoby dużej ilości danych, czasu i umiejętności, co nie miałoby sensu, gdyby można było po prostu wykorzystać istniejący model podobny do tego, który planujesz wytrenować. Dlatego, jeśli chcesz poświęcić mniej czasu i pieniędzy na trenowanie modelu, spróbuj wytrenować własny model metodą transferu. Teraz możesz zobaczyć: Przewodniki online po narzędziach AI, które pomogą Ci odkryć lub znaleźć najlepsze zastosowanie AI.